Partie 5 - Threads
Support de présentationIntroduction
Threads et processus
Un thread (fil d’exécution), ou processus léger, est une unité d’exécution à l’intérieur d’un processus. Contrairement aux processus, les threads d’un même programme partagent la même mémoire (code, données, heap) et les descripteurs de fichier, mais disposent de leur propre stack et de leur propre program counter. Le program counter (compteur ordinal) est le registre du processeur qui contient l’adresse de la prochaine instruction à exécuter.
Quand on lance un programme, le processus créé n’a qu’un seul thread, le thread principal, qui exécute main.
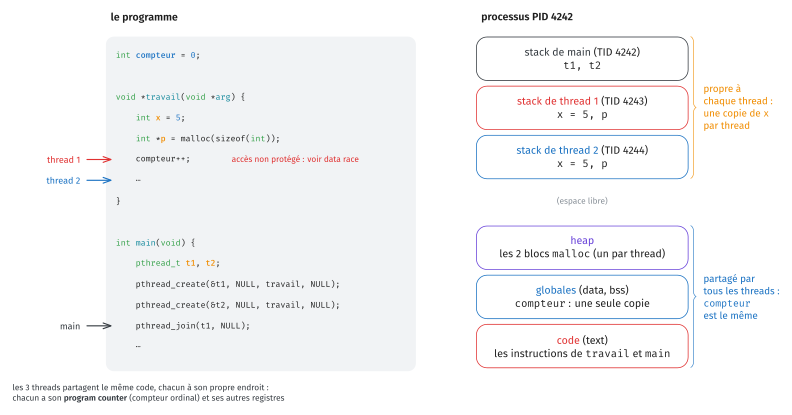
Avec pthread_create, main démarre un nouveau thread dans le même processus : ce thread exécute une fonction choisie par le programme (travail dans le schéma ci-dessous), pendant que main continue d’exécuter la suite de son propre code.
Il y a alors deux exécutions en cours, dans le même programme et la même mémoire.
C’est la différence avec fork (partie Processus) :
forkcrée un deuxième processus, avec sa propre copie de la mémoire : une variable modifiée par l’un ne change pas chez l’autrepthread_createcrée un deuxième thread dans le même processus : il n’y a qu’une mémoire, et une variable globale modifiée par un thread est modifiée pour tous
Dans le schéma, main crée deux threads qui exécutent tous les deux la fonction travail.
Chaque thread a son propre stack, donc sa propre variable locale x, et son propre program counter (la ligne qu’il exécute) ; la variable globale compteur, la heap et le code n’existent qu’en un exemplaire, partagé.
Conséquences :
une variable globale ou un bloc alloué avec
mallocest visible par tous les threads : c’est ce qui rend le partage de données facile, mais aussi dangereux (voir Synchronisation)une variable locale vit dans le stack d’un seul thread, et disparaît quand la fonction qui la déclare se termine
tous les threads d’un processus ont le même PID (getpid()), mais chacun a son propre identifiant de thread, le TID (gettid()) ; pour le thread principal, TID = PID
Avantages :
partage facile de données (même mémoire)
création et destruction plus rapides que celles d’un processus
communication plus simple (pas besoin de mécanismes IPC lourds, voir Communication inter-processus)
Inconvénients :
risques de data race (accès concurrent non synchronisé)
synchronisation nécessaire (mutex, atomiques, variables de condition)
un crash d’un thread peut faire planter tout le processus
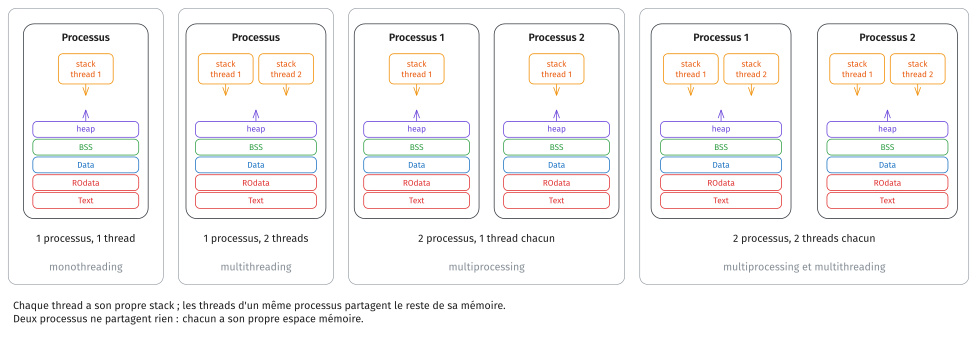
Voici la différence entre des applications avec ou sans multithreading ou multiprocessing :
1 processus - 1 thread (monoprocessing et monothreading) : cas par défaut, il y a un stack pour le thread principal (main thread)
1 processus - 2 threads (multithreading) : on crée un thread en plus du thread principal
2 processus - 1 thread par processus (multiprocessing) : on a deux espaces mémoire avec un thread principal chacun
2 processus - 2 threads par processus (multithreading et multiprocessing) : chaque processus a deux threads (le thread principal et un second)
Cas d’utilisation
Cas d’utilisation de threads :
serveurs web multi-clients : chaque requête HTTP peut être gérée par un thread, avec partage du cache et des données globales
applications interactives : séparer l’interface utilisateur (UI) et le traitement lourd pour éviter le blocage (ex. un éditeur ou un jeu vidéo)
calcul parallèle : diviser un gros calcul en plusieurs tâches parallèles sur des cœurs différents
producteur / consommateur : un thread lit des données (entrée clavier, socket réseau, fichier) pendant qu’un autre les traite
simulations : gestion de plusieurs entités indépendantes (ex. particules, joueurs dans un jeu en réseau)
Cas d’utilisation de processus (fork, mémoire isolée) :
isolation forte : le crash d’un processus n’impacte pas les autres
sécurité : exécution de code non fiable à part (ex. plugins, sandbox)
services indépendants : exécution d’outils externes
multi-utilisateurs : chaque utilisateur dispose de son propre espace mémoire
POSIX threads
L’API standard sous Linux est Pthreads (POSIX threads), disponible avec l’en-tête <pthread.h> (voir man 7 pthreads).
Il existe aussi une API de threads dans la norme C11 (<threads.h>), non traitée dans ce cours.
Le principe :
pthread_createcrée un thread, qui commence aussitôt à exécuter la fonction qu’on lui donnepthread_joinattend la fin d’un thread (et libère ses ressources). Sans cette attente, lorsquemainse termine (returnouexit), tous les threads sont interrompusla fonction exécutée par le thread a toujours la signature
void *ma_fonction(void *arg): elle reçoit un seul argument de typevoid *(pour en passer plusieurs, on utilise une structure) et retourne unvoid *
Rappel : pointeur de fonction et void *
L’API pthread utilise deux notions de la partie Bases de C :
le nom d’une fonction, sans parenthèses, est son adresse (voir Pointeurs de fonctions) : on écrit
pthread_create(&tid, NULL, ma_fonction, &valeur). Avecma_fonction(), on appellerait la fonction au lieu de la donner au threadun
void *est une adresse sans type : on peut y mettre l’adresse de n’importe quelle variable (&valeur,¶ms). Dans le thread, on rangeargdans un pointeur du bon type,int *val = arg;(conversion implicite en C, ou explicite avec(int *)arg: les deux sont valides). Rien ne vérifie que c’est le bon type : c’est à vous de rester cohérent entrepthread_createet la fonction du thread
pthread_join a besoin d’une troisième notion, l’adresse d’un pointeur (void **), détaillée plus bas.
Pour la compilation, il ne faut pas oublier d’ajouter -pthread aux flags :
gcc -std=c2x -Wall -Wextra -pedantic -g -pthread mon_prog.c
Créer et attendre un thread
La création se fait avec pthread_create :
int pthread_create(pthread_t *thread,
                   const pthread_attr_t *attr,
                   void *(*start_routine)(void *),
                   void *arg);
thread: pointeur où sera stocké l’identifiant du threadattr: attributs du thread (souventNULL)start_routine: fonction exécutée par le threadarg: argument passé à cette fonction
Retourne 0 en cas de succès, sinon un code d’erreur (errno n’est pas modifié).
Le thread commence aussitôt start_routine(arg), en concurrence avec l’appelant (en parallèle s’il y a plusieurs cœurs). L’identifiant écrit dans *thread sert ensuite à pthread_join.
L’attente du thread se fait avec pthread_join :
int pthread_join(pthread_t thread, void **retval);
thread: l’identifiant du threadretval: adresse d’unvoid *qui recevra la valeur retournée par le thread (NULLpour l’ignorer)
Retourne 0 en cas de succès, sinon un code d’erreur (errno n’est pas modifié).
Le thread appelant (souvent le thread principal, mais n’importe quel thread peut faire le join) reste bloqué dans pthread_join jusqu’à la fin du thread.
Un thread peut aussi se terminer en appelant pthread_exit :
void pthread_exit(void *retval);
retval: la valeur retournée par le thread (NULLsi aucune valeur)
Ne retourne jamais : le thread appelant se termine.
Elle permet de retourner un pointeur sur n’importe quel type (void *) et a le même effet que return retval; dans la fonction du thread.
Dans la fonction du thread, on écrit plutôt return retval; ; pthread_exit sert surtout à terminer le thread depuis une fonction qu’il a appelée.
Le programme principal récupère la valeur avec pthread_join.
Codes d’erreur pthread
Attention : comme les fonctions pthread retournent le code d’erreur au lieu de le placer dans errno, perror afficherait un message sans rapport : on utilise strerror(err) (<string.h>) sur la valeur retournée, comme dans l’exemple ci-dessous.
Fonctions |
Retour en cas d’erreur |
Cause de l’erreur |
Affichage |
|---|---|---|---|
appels système et libc ( |
|
dans |
|
fonctions pthread |
un nombre différent de 0 |
c’est la valeur retournée |
|
Exemple sans retour de valeur :
 1 #include <pthread.h>
 2 #include <stdio.h>
 3 #include <stdlib.h>
 4 #include <string.h>
 5
 6 void *ma_fonction(void *arg) {
 7     int *val = arg;
 8     printf("Hello depuis le thread, arg = %d\n", *val);
 9     return NULL;
10 }
11
12 int main(void) {
13     pthread_t tid;
14     int valeur = 42;
15
16     int err = pthread_create(&tid, NULL, ma_fonction, &valeur);
17     if (err != 0) {
18         fprintf(stderr, "pthread_create: %s\n", strerror(err));
19         exit(EXIT_FAILURE);
20     }
21
22     // attendre la fin du thread
23     err = pthread_join(tid, NULL);
24     if (err != 0) {
25         fprintf(stderr, "pthread_join: %s\n", strerror(err));
26         exit(EXIT_FAILURE);
27     }
28
29     printf("Thread terminé !\n");
30     return EXIT_SUCCESS;
31 }
Sortie :
Hello depuis le thread, arg = 42
Thread terminé !
Dans la suite, pour raccourcir, la plupart des exemples ne testent pas le retour de pthread_create et pthread_join : dans vos programmes, testez-le comme ci-dessus.
Identifiant du thread : gettid
Chaque thread a aussi un identifiant noyau, le TID, obtenu avec gettid :
pid_t gettid(void);
Retourne le TID (Thread ID) du thread appelant, attribué par le noyau. Cet appel n’échoue jamais.
gettid est propre à Linux (non portable). Elle n’est déclarée dans <unistd.h> qu’avec #define _GNU_SOURCE placé avant le premier #include : sinon, gcc signale implicit declaration of function 'gettid'.
Attention à ne pas confondre le TID (identifiant noyau, du même type qu’un PID, voir getpid) avec le pthread_t rempli par pthread_create (identifiant de la bibliothèque pthread, utilisé pour le pthread_join).
Que se passe-t-il à la création d’un thread ?
pthread_create ne fait pas qu’appeler la fonction : il crée un nouveau thread, puis retourne aussitôt.
À partir de là, deux threads avancent chacun de leur côté : main continue après pthread_create, et le nouveau thread exécute ma_fonction.
pthread_join est un point de rendez-vous : main y reste bloqué jusqu’à la fin du thread.
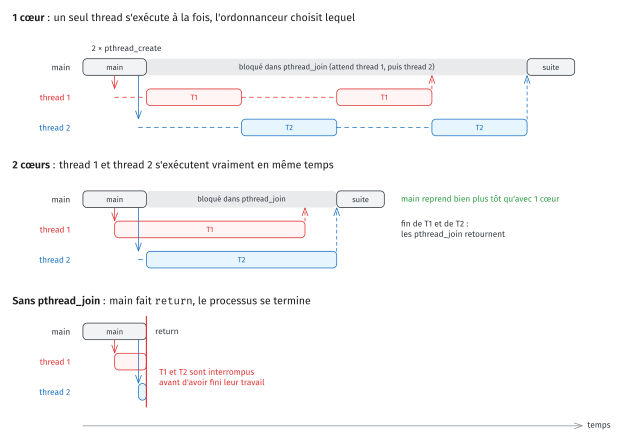
Sur un seul cœur, l’ordonnanceur (voir Ordonnanceur et priorités) donne le processeur à chaque thread à tour de rôle, par petites tranches de temps
Sur plusieurs cœurs, plusieurs threads s’exécutent vraiment en même temps : c’est ce qui permet d’accélérer un calcul en le répartissant entre des threads
Sans
pthread_join,mainpeut se terminer avant les threads : le processus s’arrête et les threads sont interrompus en plein travail
Comme après un fork, c’est l’ordonnanceur qui décide quel thread s’exécute et à quel moment : l’ordre des affichages de différents threads change d’une exécution à l’autre.
Chaque printf est protégé par un verrou interne, donc une ligne écrite en un seul appel n’est pas coupée au milieu, mais l’ordre des lignes n’est pas prévisible.
Retourner une valeur
Exemple partiel avec une valeur retournée :
void *ma_fonction(void *arg) {
    (void)arg; // évite le warning « paramètre inutilisé »
    // on ne doit pas retourner l'adresse d'une variable locale (dans le stack) :
    // elle est détruite à la fin de la fonction !
    int *res = malloc(sizeof(int));
    if (res == NULL) {
        return NULL;
    }
    *res = 1234;
    return res; // ou pthread_exit(res);
}

// main ...
void *retour;
pthread_join(tid, &retour); // pthread_join écrit un void * dans retour
int *resultat = retour;
if (resultat != NULL) {
    printf("Résultat : %d\n", *resultat);
    free(resultat); // main libère ce que le thread a alloué
}
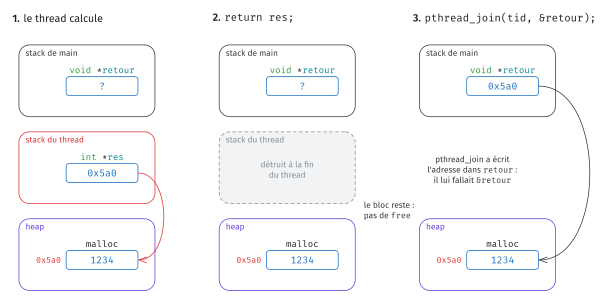
Le résultat est alloué dans la heap : il survit à la fin du thread, contrairement au stack du thread.
pthread_join doit ensuite écrire l’adresse de ce résultat dans votre variable retour : il lui faut donc l’adresse de retour, d’où &retour (de type void **), comme scanf("%d", &x) a besoin de &x pour écrire dans x (voir Passage par valeur, passage par adresse).
Passer plusieurs arguments
La signature de la fonction exécutée par le thread est void *ma_fonction(void *), donc elle prend un seul argument et ne retourne qu’un élément.
Dans ce cas, comment faire si l’on veut passer plusieurs arguments à la fonction ?
La solution est d’utiliser une structure !
typedef struct {
double valeur;
char *message;
} params_t;
void *ma_fonction(void *arg) {
params_t *parametres = arg;
printf("%f, %s\n", parametres->valeur, parametres->message);
return NULL;
}
int main(void) {
pthread_t tid;
params_t params = {3.14, "Hello"};
pthread_create(&tid, NULL, ma_fonction, ¶ms);
pthread_join(tid, NULL);
return 0;
}
La structure regroupe les valeurs à transmettre (ici un double et un char *).
Durée de vie de l’argument
Le thread reçoit une adresse : la variable pointée doit exister tant que le thread l’utilise (et ne pas être modifiée sans synchronisation) (voir Durée de vie (lifetime)).
Dans l’exemple ci-dessus, params est une variable locale de main, qui ne se termine qu’après le pthread_join : pas de problème.
En revanche, si la fonction qui crée le thread se termine avant lui, sa variable locale est détruite alors que le thread peut encore la lire :
void lancer_thread(pthread_t *tid) {
    int valeur = 42;
    pthread_create(tid, NULL, ma_fonction, &valeur); // FAUX
} // valeur est détruite ici, le thread lit peut-être une case réutilisée
On alloue alors l’argument dans la heap, et on décide qui le libère (voir Propriété de la mémoire) : ici, le thread devient propriétaire de son argument et le libère quand il n’en a plus besoin.
void *ma_fonction(void *arg) {
    int *val = arg;
    printf("valeur = %d\n", *val);
    free(val); // le thread libère son argument
    return NULL;
}

void lancer_thread(pthread_t *tid) {
    int *valeur = malloc(sizeof(int));
    if (valeur == NULL) {
        perror("malloc");
        exit(EXIT_FAILURE);
    }
    *valeur = 42;
    pthread_create(tid, NULL, ma_fonction, valeur); // le thread devient propriétaire
}
Créer N threads dans une boucle
Pour créer plusieurs threads, on utilise un tableau de pthread_t, une boucle de création, puis une boucle de pthread_join.
Chaque thread doit recevoir sa propre donnée.
Avertissement
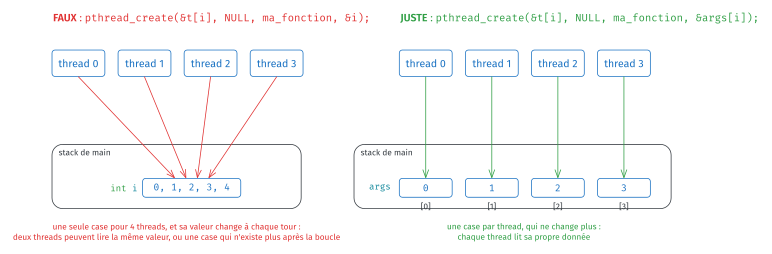
Piège classique : créer des threads dans une boucle en leur passant l’adresse de la variable de boucle.
for (int i = 0; i < 4; i++) {
    pthread_create(&t[i], NULL, ma_fonction, &i); // FAUX
}
Tous les threads reçoivent la même adresse &i : quand un thread lit *arg, i a peut-être déjà changé (plusieurs threads voient la même valeur), voire n’existe plus (fin de la boucle).
Il faut donner à chaque thread sa propre donnée : un tableau (d’entiers ou de structures) dont on passe &args[i], ou une structure allouée avec malloc pour chaque thread (libérée par le thread).
Exemple : chaque thread calcule le carré d’un nombre.
La structure contient à la fois l’entrée (n) et la sortie (resultat) : le thread écrit son résultat dans sa propre case du tableau, ce qui évite un malloc pour le retour.
 1 #include <pthread.h>
 2 #include <stdio.h>
 3 #include <stdlib.h>
 4
 5 #define NB_THREADS 4
 6
 7 typedef struct {
 8     int n;        // entrée
 9     int resultat; // sortie
10 } carre_t;
11
12 void *carre(void *arg) {
13     carre_t *donnees = arg;
14     donnees->resultat = donnees->n * donnees->n; // écrit dans sa propre case
15     return NULL;
16 }
17
18 int main(void) {
19     pthread_t threads[NB_THREADS];
20     carre_t donnees[NB_THREADS]; // une case par thread
21
22     for (int i = 0; i < NB_THREADS; i++) { // chacun reçoit l'adresse de SA case
23         donnees[i].n = 5 * (i + 1); // 5, 10, 15, 20
24         pthread_create(&threads[i], NULL, carre, &donnees[i]);
25     }
26     for (int i = 0; i < NB_THREADS; i++) { // attendre, puis lire le résultat
27         pthread_join(threads[i], NULL);
28         printf("%d * %d = %d\n", donnees[i].n, donnees[i].n, donnees[i].resultat);
29     }
30     return EXIT_SUCCESS;
31 }
Résultat :
5 * 5 = 25
10 * 10 = 100
15 * 15 = 225
20 * 20 = 400
Le tableau donnees est une variable locale de main, qui ne se termine qu’après les pthread_join : il existe pendant toute la vie des threads, pas besoin de malloc.
main ne lit donnees[i].resultat qu”après le pthread_join du thread i : à ce moment, le thread a fini d’écrire.
Threads détachés
Par défaut, un thread créé avec pthread_create est joinable, c’est-à-dire qu’un autre thread (en général le thread principal) peut (et doit) appeler pthread_join dessus pour :
récupérer sa valeur de retour
libérer les ressources associées au thread
Si un thread joinable n’est jamais attendu avec pthread_join, ses ressources (son stack et sa structure de gestion interne) ne sont pas libérées avant la fin du processus : dans un programme qui crée beaucoup de threads (un serveur), c’est une fuite mémoire (zombie thread), comme un processus zombie qu’aucun wait ne récupère.
Pour éviter cela, un thread peut être détaché (detached) avec pthread_detach :
int pthread_detach(pthread_t thread);
thread: l’identifiant du thread à détacher
Retourne 0 en cas de succès, sinon un code d’erreur (errno n’est pas modifié).
Un thread détaché :
libère automatiquement ses ressources lorsqu’il se termine
ne peut plus être attendu avec
pthread_join(sa valeur de retour est perdue)est lui aussi interrompu si
mainse termine (returnouexit) : détacher ne garde pas le thread en vieest typiquement utilisé dans les serveurs (un thread par client)
pthread_t tid;
pthread_create(&tid, NULL, ma_fonction, NULL);

pthread_detach(tid); // le thread devient détaché
Ici, il est ensuite interdit d’appeler pthread_join(tid, ...).
Pour aller plus loin : créer directement un thread détaché
Le deuxième paramètre de pthread_create (attr) permet de choisir les attributs du thread, par exemple de le créer directement détaché.
Les attributs se préparent avec :
int pthread_attr_init(pthread_attr_t *attr);
int pthread_attr_setdetachstate(pthread_attr_t *attr, int detachstate);
int pthread_attr_destroy(pthread_attr_t *attr);
attr: l’objet d’attributs, à passer ensuite àpthread_createdetachstate:PTHREAD_CREATE_DETACHED(thread créé détaché) ouPTHREAD_CREATE_JOINABLE(le défaut)
Retourne 0 en cas de succès, sinon un code d’erreur (errno n’est pas modifié).
pthread_attr_init remplit attr avec les valeurs par défaut, pthread_attr_destroy le libère : les threads déjà créés avec lui ne sont pas affectés.
Exemple :
pthread_t tid;
pthread_attr_t attr;

pthread_attr_init(&attr);
pthread_attr_setdetachstate(&attr, PTHREAD_CREATE_DETACHED);

pthread_create(&tid, &attr, ma_fonction, NULL);

pthread_attr_destroy(&attr);
Synchronisation
Comme plusieurs threads partagent les mêmes variables globales ou les données de la heap grâce aux pointeurs, il faut éviter les accès concurrents non contrôlés. Sinon, on obtient des résultats incohérents. On parle de data race (course aux données) lorsque plusieurs threads accèdent à la même variable sans synchronisation, avec au moins une écriture : c’est un comportement indéfini (UB) en C. C’est une forme de race condition (situation de compétition), où le résultat dépend de l’ordre d’exécution des threads.
Exemple classique : incrémenter une variable globale depuis deux threads.
 1#include <pthread.h>
 2#include <stdio.h>
 3
 4int compteur = 0;
 5
 6void *incremente(void *arg) {
 7    (void)arg;
 8    for (int i = 0; i < 1000000; i++) {
 9        compteur++;
10    }
11    return NULL;
12}
13
14int main(void) {
15    pthread_t t1, t2;
16    pthread_create(&t1, NULL, incremente, NULL);
17    pthread_create(&t2, NULL, incremente, NULL);
18
19    pthread_join(t1, NULL);
20    pthread_join(t2, NULL);
21
22    printf("Compteur final = %d\n", compteur);
23    return 0;
24}
Résultats observés (programme compilé sans optimisation, -O0, le défaut de gcc), qui changent d’une exécution à l’autre :
Compteur final = 1048495
Compteur final = 1102100
Compteur final = 1069216
Compteur final = 1087636
alors que le résultat attendu est 2 000 000 (chaque thread fait 1 000 000 incréments).
Pourquoi ce bug ?
L’opération compteur++ n’est pas atomique, elle se décompose en plusieurs instructions machine :
Lire la valeur actuelle de
compteurAjouter 1
Réécrire la nouvelle valeur dans
compteur
Ces étapes passent par un registre du processeur : chaque cœur a les siens, la mémoire est commune.
Un thread peut être interrompu entre deux de ces instructions, ou s’exécuter au même moment qu’un autre thread sur un autre cœur.
Si deux threads exécutent cette séquence en même temps, ils peuvent interférer, par exemple avec compteur = 50 :
thread 1 et thread 2 lisent tous les deux
50dans leur registrechacun calcule
50 + 1 = 51thread 1 écrit
51danscompteur, puis thread 2 écrit aussi51
Résultat final, compteur = 51, alors qu’on aurait dû avoir compteur = 52 : l’incrément de thread 1 est perdu.
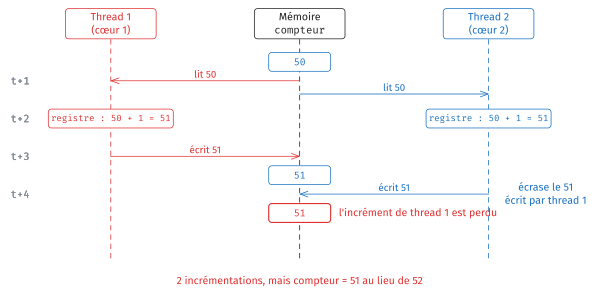
Ce phénomène se produit de très nombreuses fois dans la boucle, ce qui explique pourquoi le résultat final varie et est presque toujours inférieur à 2 000 000.
Avertissement
Avec -O2, gcc transforme la boucle en un seul compteur += 1000000 et le programme affiche en pratique 2 000 000 à chaque exécution.
La data race est pourtant toujours là (le comportement reste indéfini).
Un résultat correct ne prouve pas l’absence de data race : pour la détecter, on utilise l’outil helgrind de valgrind (voir la page Outils) :
gcc -std=c2x -Wall -Wextra -pedantic -g -pthread mon_prog.c
valgrind --tool=helgrind ./a.out
helgrind signale Possible data race avec le numéro de la ligne concernée, et Locks held: none (aucun verrou n’était pris).
Solution : utiliser des mécanismes de synchronisation (mutex, opérations atomiques, etc.) pour rendre l’incrément atomique.
Déclarer compteur en volatile (voir Autres mots-clés) ne suffit pas : volatile ne protège pas d’une data race et ne rend pas compteur++ atomique.
Mutex
Une section critique est une portion de code qui accède à une donnée partagée et que deux threads ne doivent pas exécuter en même temps (ici, compteur++).
Un mutex (mutual exclusion, verrou d’exclusion mutuelle) est un verrou qui garantit qu’un seul thread exécute la section critique à la fois : comme une clé unique, celui qui la détient entre, les autres attendent qu’elle soit rendue.
Avec les pthreads, le mutex est un pthread_mutex_t qui peut être initialisé statiquement ou dynamiquement.
L’initialisation dynamique et la libération se font avec pthread_mutex_init et pthread_mutex_destroy :
int pthread_mutex_init(pthread_mutex_t *mutex, const pthread_mutexattr_t *attr);
int pthread_mutex_destroy(pthread_mutex_t *mutex);
mutex: le mutexattr: attributs du mutex (NULLpour les attributs par défaut)
Retourne 0 en cas de succès, sinon un code d’erreur (errno n’est pas modifié).
Initialisation statique, sans appel de fonction : pthread_mutex_t verrou = PTHREAD_MUTEX_INITIALIZER;.
pthread_mutex_destroy est nécessaire après une initialisation dynamique, facultative après une initialisation statique.
Il peut ensuite être utilisé en le verrouillant avec pthread_mutex_lock avant la section critique puis en le déverrouillant avec pthread_mutex_unlock après la section critique :
int pthread_mutex_lock(pthread_mutex_t *mutex);
int pthread_mutex_unlock(pthread_mutex_t *mutex);
mutex: le mutex à verrouiller ou à déverrouiller
Retourne 0 en cas de succès, sinon un code d’erreur (errno n’est pas modifié).
Si un thread essaie d’appeler pthread_mutex_lock sur un mutex déjà verrouillé, il est mis en attente jusqu’à ce que le mutex soit déverrouillé.
Exemple :
 1 #include <pthread.h>
 2 #include <stdio.h>
 3
 4 pthread_mutex_t verrou = PTHREAD_MUTEX_INITIALIZER;
 5 int compteur = 0;
 6
 7 void *incremente(void *arg) {
 8     (void)arg;
 9     for (int i = 0; i < 1000000; i++) {
10         pthread_mutex_lock(&verrou);
11         compteur++;
12         pthread_mutex_unlock(&verrou);
13     }
14     return NULL;
15 }
16
17 int main(void) {
18     pthread_t t1, t2;
19     pthread_create(&t1, NULL, incremente, NULL);
20     pthread_create(&t2, NULL, incremente, NULL);
21
22     pthread_join(t1, NULL);
23     pthread_join(t2, NULL);
24
25     printf("Compteur final = %d\n", compteur);
26     return 0;
27 }
Grâce au mutex, il n’y a plus de data race et le compteur vaut bien 2 000 000 à la fin.
Il est aussi possible de ranger le mutex dans une structure, à côté de la donnée qu’il protège.
Fonctionnement avec le mutex verrouillé avant la modification de la variable :
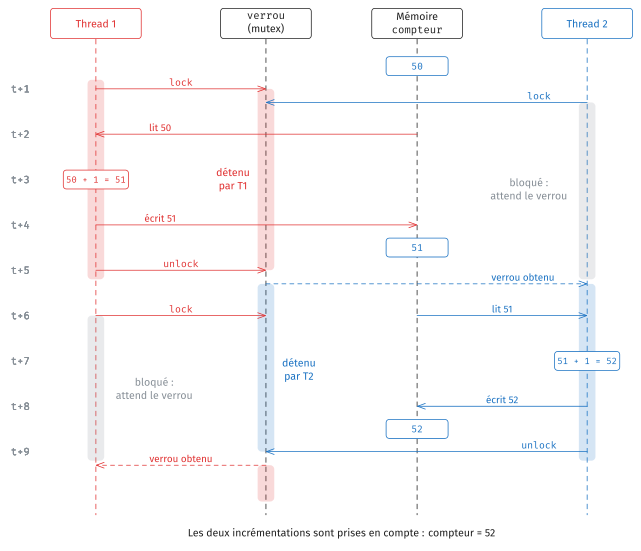
Il est important de réduire au maximum la section critique pour que les autres threads attendent le moins longtemps possible le mutex.
Avertissement
Chaque lock doit être suivi d’un unlock, sur tous les chemins : un return (ou un break) au milieu de la section critique laisse le mutex verrouillé, et tous les threads qui le demandent ensuite restent bloqués pour toujours.
pthread_mutex_lock(&verrou);
if (compteur >= MAX) {
    pthread_mutex_unlock(&verrou); // à ne pas oublier avant le return
    return NULL;
}
compteur++;
pthread_mutex_unlock(&verrou);
Opérations atomiques (C11)
Pour des compteurs simples, on peut simplifier la synchronisation en utilisant des opérations atomiques.
Une opération est dite atomique si elle est indivisible : aucun autre thread, même sur un autre cœur, ne peut voir ou modifier la variable au milieu de l’opération.
La norme C11 introduit les opérations atomiques avec l’en-tête <stdatomic.h> qui apporte des types atomiques (atomic_int, atomic_bool…) et un ensemble de fonctions pour travailler avec ces types.
Exemple avec un atomic_int :
#include <stdatomic.h>

atomic_int compteur = 0;

void *incremente(void *arg) {
    (void)arg; // évite le warning « paramètre inutilisé »
    for (int i = 0; i < 1000000; i++) {
        atomic_fetch_add(&compteur, 1);
    }
    return NULL;
}
Avec cet atomic_int, la lecture, la modification et l’écriture de compteur forment une seule opération indivisible, sans mutex.
Sur un atomic_int, l’écriture compteur++ est elle aussi atomique (elle équivaut à atomic_fetch_add(&compteur, 1)) ; sur un int ordinaire, elle ne l’est pas.
Les fonctions courantes de <stdatomic.h> (forme simplifiée, pour un atomic_int) :
int atomic_load(atomic_int *obj);
void atomic_store(atomic_int *obj, int value);
int atomic_fetch_add(atomic_int *obj, int value);
int atomic_fetch_sub(atomic_int *obj, int value);
obj: adresse de la variable atomique (par exemple&compteur)value: la valeur à écrire (atomic_store), à ajouter (atomic_fetch_add) ou à retirer (atomic_fetch_sub)
atomic_load retourne la valeur lue ; atomic_fetch_add et atomic_fetch_sub retournent la valeur avant l’opération ; atomic_store ne retourne rien. Ces fonctions n’échouent pas.
Ces fonctions sont génériques : les signatures ci-dessus sont celles pour un atomic_int, elles existent de la même façon pour tous les types atomiques (atomic_bool, atomic_long…).
atomic_load sert à lire la valeur pendant que d’autres threads la modifient (après les pthread_join, compteur peut aussi être lu directement).
Ces fonctions et types sont donc utiles pour une variable simple (un compteur, un drapeau) ; pour de plus gros blocs de code, il faudra utiliser des mutex.
Variables de condition
Principe
Une variable de condition avec Pthreads (pthread_cond_t) permet de faire attendre un thread jusqu’à ce qu’une condition devienne vraie.
Elle s’utilise toujours avec un mutex. Exemples d’usage :
producteur / consommateur
files de messages
Fonctions principales :
int pthread_cond_wait(pthread_cond_t *cond, pthread_mutex_t *mutex);
int pthread_cond_signal(pthread_cond_t *cond);
int pthread_cond_broadcast(pthread_cond_t *cond);
cond: la variable de conditionmutex: le mutex associé à la condition, verrouillé par le thread qui appellepthread_cond_wait
Retourne 0 en cas de succès, sinon un code d’erreur (errno n’est pas modifié).
pthread_cond_wait libère le mutex et met le thread en attente (atomiquement), puis reprend le mutex avant de retourner.
pthread_cond_signal réveille au moins un thread en attente (aucun effet si aucun thread n’attend : le signal n’est pas mémorisé).
pthread_cond_broadcast réveille tous les threads en attente.
Il faut toujours faire les wait dans une boucle while qui reteste la condition, car :
POSIX autorise les réveils intempestifs (spurious wakeups) :
pthread_cond_waitpeut retourner sans qu’aucun signal n’ait été envoyéun autre thread peut avoir modifié la condition entre le signal et la reprise du mutex
C’est le fait de tester la condition avant d’attendre, en détenant le mutex, qui évite de rater un signal envoyé avant le wait.
Le point le plus difficile est ce que fait pthread_cond_wait avec le mutex : comme dans une salle d’attente, le thread rend la clé en entrant (sinon, aucun autre thread ne pourrait prendre le mutex pour modifier la condition) et la reprend en sortant, avant de retester la condition.
Le schéma suivant déroule l’exemple ci-dessous, quand le consommateur arrive avant que la donnée soit disponible :
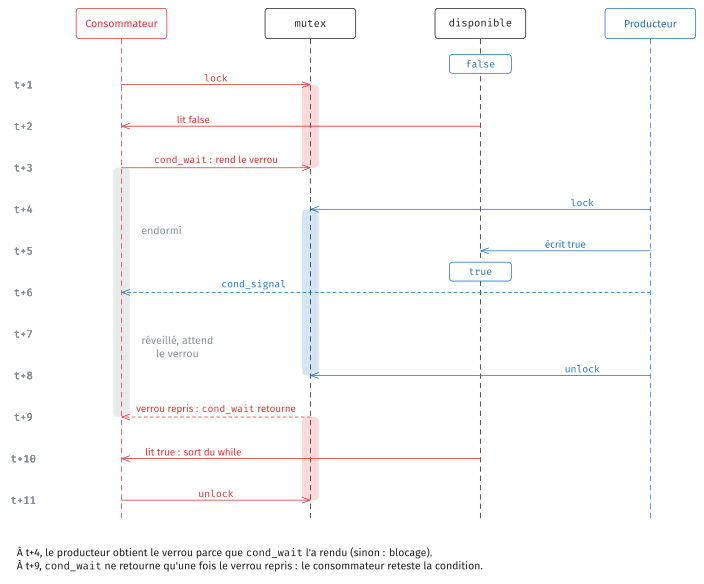
Comme un mutex, une variable de condition peut être initialisée statiquement ou dynamiquement.
L’initialisation dynamique et la libération se font avec pthread_cond_init et pthread_cond_destroy :
int pthread_cond_init(pthread_cond_t *cond, const pthread_condattr_t *attr);
int pthread_cond_destroy(pthread_cond_t *cond);
cond: la variable de conditionattr: attributs de la variable de condition (NULLpour les attributs par défaut)
Retourne 0 en cas de succès, sinon un code d’erreur (errno n’est pas modifié).
Initialisation statique, sans appel de fonction : pthread_cond_t cond = PTHREAD_COND_INITIALIZER;.
pthread_cond_destroy est nécessaire après une initialisation dynamique, facultative après une initialisation statique. Aucun thread ne doit être en attente sur la condition au moment de sa destruction.
Exemple
 1#include <pthread.h>
 2#include <stdbool.h>
 3#include <stdio.h>
 4
 5int donnee = 0;
 6bool disponible = false;
 7pthread_mutex_t mutex = PTHREAD_MUTEX_INITIALIZER;
 8pthread_cond_t cond = PTHREAD_COND_INITIALIZER;
 9
10void *producteur(void *arg) {
11    (void)arg;
12    pthread_mutex_lock(&mutex);
13    donnee = 42;       // réalise son calcul
14    disponible = true;
15    pthread_cond_signal(&cond); // réveille le consommateur
16    pthread_mutex_unlock(&mutex);
17    return NULL;
18}
19
20void *consommateur(void *arg) {
21    (void)arg;
22    pthread_mutex_lock(&mutex);
23    while (!disponible) {
24        // relâche le mutex et attend, puis reprend le mutex au réveil
25        pthread_cond_wait(&cond, &mutex);
26    }
27    disponible = false;
28    printf("Consommateur : donnée reçue = %d\n", donnee);
29    pthread_mutex_unlock(&mutex);
30    return NULL;
31}
32
33int main(void) {
34    pthread_t prod, cons;
35    pthread_create(&cons, NULL, consommateur, NULL);
36    pthread_create(&prod, NULL, producteur, NULL);
37    pthread_join(prod, NULL);
38    pthread_join(cons, NULL);
39    return 0;
40}
Sortie :
Consommateur : donnée reçue = 42
Erreurs fréquentes avec les threads
Adresse de la variable de boucle : passer
&iàpthread_createdans une boucle donne la même adresse à tous les threads (voir Créer N threads dans une boucle)Argument détruit trop tôt : variable locale d’une fonction qui se termine avant le thread (voir Durée de vie de l’argument)
join oublié :
mainse termine et interrompt les threads (voir Que se passe-t-il à la création d’un thread ?), ou les ressources du thread ne sont pas libérées avant la fin du processusData race : variable partagée modifiée sans mutex ni atomique (voir Synchronisation)
unlock oublié sur un
returnau milieu d’une section critique : les autres threads restent bloqués (voir Mutex)if au lieu de while autour de
pthread_cond_wait(voir Variables de condition)
Interblocages (deadlocks)
Un deadlock (ou interblocage) survient lorsque deux threads (ou plus) attendent chacun un verrou détenu par l’autre : ils restent bloqués pour toujours.
Par exemple, le thread 1 prend mutex_A puis demande mutex_B, pendant que le thread 2 prend mutex_B puis demande mutex_A.
Pour l’éviter, tous les threads doivent prendre les verrous dans le même ordre (ici, toujours mutex_A avant mutex_B).
Pour aller plus loin : exemple de deadlock et bonnes pratiques
pthread_mutex_t mutex_A = PTHREAD_MUTEX_INITIALIZER;
pthread_mutex_t mutex_B = PTHREAD_MUTEX_INITIALIZER;

void *thread1_func(void *arg) {
    (void)arg;
    pthread_mutex_lock(&mutex_A);    // Thread 1 verrouille A
    sleep(1);                        // simule un calcul (<unistd.h>)
    pthread_mutex_lock(&mutex_B);    // Thread 1 attend B (bloqué !)

    // Section critique utilisant A et B

    pthread_mutex_unlock(&mutex_B);
    pthread_mutex_unlock(&mutex_A);
    return NULL;
}

void *thread2_func(void *arg) {
    (void)arg;
    pthread_mutex_lock(&mutex_B);    // Thread 2 verrouille B
    sleep(1);                        // simule un calcul
    pthread_mutex_lock(&mutex_A);    // Thread 2 attend A (bloqué !)

    // Section critique utilisant A et B

    pthread_mutex_unlock(&mutex_A);
    pthread_mutex_unlock(&mutex_B);
    return NULL;
}
Si chaque thread prend son premier verrou avant que l’autre ait pris son second, chacun attend que l’autre libère son verrou : blocage permanent.
Le deadlock n’est pas certain, il dépend de l’entrelacement des threads (ici, le sleep le rend quasi certain).
Avec plus de deux verrous, on fixe un ordre global : avec 3 mutex ordonnés A < B < C, un thread peut prendre B seul, mais un thread qui détient B ne doit jamais demander A, et un thread qui détient C ne doit demander ni A ni B.
Bonnes pratiques :
Minimiser le nombre de verrous : moins de mutex = moins de risques
Ordre global cohérent : documenter et respecter l’ordre de verrouillage
Verrouiller le minimum de temps : réduire la durée des sections critiques
Verrouiller tout d’un coup : acquérir tous les verrous nécessaires au début de la section critique, dans l’ordre global, ou avec
pthread_mutex_trylocken relâchant les verrous déjà pris en cas d’échecTests avec différents timings : ajouter des pauses (
sleep) pour révéler les deadlocks
Autres problèmes
Livelock : les threads ne sont pas bloqués, mais passent leur temps à réagir les uns aux autres sans progresser
Famine (starvation) : un thread n’obtient jamais la ressource qu’il attend parce que d’autres threads la prennent toujours avant lui
Pour aller plus loin : faux partage (false sharing)
Deux threads modifient des variables différentes mais voisines en mémoire, situées dans la même ligne de cache (64 octets en général). Chaque écriture invalide la ligne dans le cache de l’autre cœur, ce qui ralentit fortement le programme. On l’évite en séparant en mémoire les données très modifiées par chaque thread (par exemple une variable locale par thread, recopiée à la fin).