Partie 3 - Mémoire
Support présentationIntroduction
Dans un système multitâche et multiutilisateur, la mémoire est une ressource partagée entre plusieurs processus (navigateur internet, jeu, IDE, serveur web, etc.) et le noyau du système. Le système doit la gérer efficacement et isoler correctement chaque processus.
Plutôt que de fournir directement les adresses physiques (adresses réelles en RAM) aux programmes, l’OS leur attribue une mémoire virtuelle : chaque processus dispose ainsi d’un espace d’adressage indépendant, ce qui offre les avantages suivants :
Isolation : un processus ne peut pas lire ou modifier la mémoire d’un autre.
Flexibilité : déplacement de processus en mémoire sans modification du code.
Optimisation : partage possible de certaines zones (ex. code exécutable) entre processus.
Support du swap : possibilité d’exécuter des programmes plus grands que la RAM.
La section Pagination et MMU montre comment une adresse virtuelle est traduite en adresse physique.
Hiérarchie mémoire
Toutes les mémoires n’offrent pas la même vitesse d’accès ni la même capacité. Le temps d’accès dépend de l’endroit où les informations sont gardées : dans le cœur du processeur, ailleurs dans le processeur, sur la carte mère (RAM) ou sur un disque. Vous aurez plus de détails sur le fonctionnement du cache et des registres dans les cours d’assembleur.
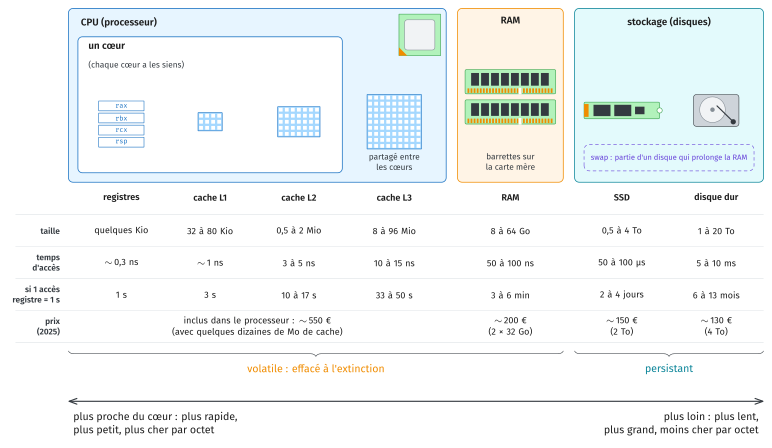
Où se trouve chaque mémoire, avec des ordres de grandeur de taille et de temps d’accès (machine de bureau récente).
Le schéma reprend celui des composants d’un ordinateur en se concentrant sur la mémoire :
les registres sont dans chaque cœur : ce sont les quelques valeurs sur lesquelles les instructions calculent directement ;
les caches L1 et L2 sont propres à chaque cœur, le cache L3 est partagé entre les cœurs. Ils gardent automatiquement une copie des données de la RAM utilisées récemment ;
la RAM contient le code et les données des programmes en cours d’exécution ;
les disques (SSD, disque dur) conservent les fichiers ; une partie d’un disque peut servir de swap (voir Optimisations matérielles et logicielles).
La ligne « si 1 accès registre = 1 s » ramène les temps à l’échelle humaine : si lire un registre prenait 1 seconde, lire la RAM prendrait quelques minutes et lire un disque dur plusieurs mois. C’est pour cela que les caches sont indispensables et que le swap ralentit fortement une machine.
Plus on se rapproche du cœur, plus la mémoire est rapide, mais petite et chère. Plus on s’en éloigne, plus elle est lente, mais grande et bon marché :
processeur : environ 550 € (AMD Ryzen 7 9800X3D ou Intel Core i9 14900K, avec quelques dizaines de Mo de cache) ; ce prix est celui du processeur entier, pas seulement du cache ;
barrettes de RAM : environ 200 € pour 2 × 32 Go ;
un SSD NVMe : environ 150 € pour 2 To ;
un HDD : environ 130 € pour 4 To.
Ces prix datent de 2025. En 2026, un kit de 2 × 32 Go coûte plus de 600 €, et les SSD et HDD coûtent environ 100 € de plus.
Note
Observer sa machine
lstopo(fenêtre graphique) ouhwloc-ls(texte), du paquethwloc, affichent les cœurs du processeur et les caches L1, L2 et L3 attachés à chacun ;lscpuaffiche le modèle du processeur et ses fréquences, etlscpu --cachesla taille de chaque niveau de cache.
Pagination et MMU
Pages
Sous les systèmes Linux modernes, la mémoire est découpée en pages de taille fixe (souvent 4 Kio, vérifiable avec getconf PAGESIZE).
La mémoire virtuelle de chaque processus est découpée en pages, la RAM en cadres (frames) de même taille.
Chaque page virtuelle utilisée est placée dans un cadre de la RAM, n’importe lequel : deux pages voisines pour le processus peuvent être très éloignées en RAM.
Une segmentation fault est un accès à une adresse interdite au processus (page qui ne lui appartient pas, ou écriture dans une page en lecture seule). Son nom vient d’un ancien mécanisme, la segmentation (mémoire découpée en segments de taille variable), remplacé aujourd’hui par la pagination.
Rôle de la MMU
La MMU (Memory Management Unit), ou unité de gestion de mémoire, est un composant matériel du processeur qui traduit les adresses virtuelles en adresses physiques à chaque accès mémoire. Pour cela, elle utilise la table des pages du processus en cours, préparée par le noyau : pour chaque page virtuelle, la table indique dans quel cadre de la RAM elle se trouve (ou qu’elle n’est pas en RAM).
Une adresse virtuelle se découpe en deux parties : le numéro de page et la position dans la page (offset). Avec des pages de 4 Kio (0x1000 octets), l’adresse 0x5123 désigne l’octet 0x123 de la page 0x5000.
La MMU remplace le numéro de page par le numéro de cadre trouvé dans la table et garde la position : si la page 0x5000 est dans le cadre 2, l’adresse physique est 0x2123.
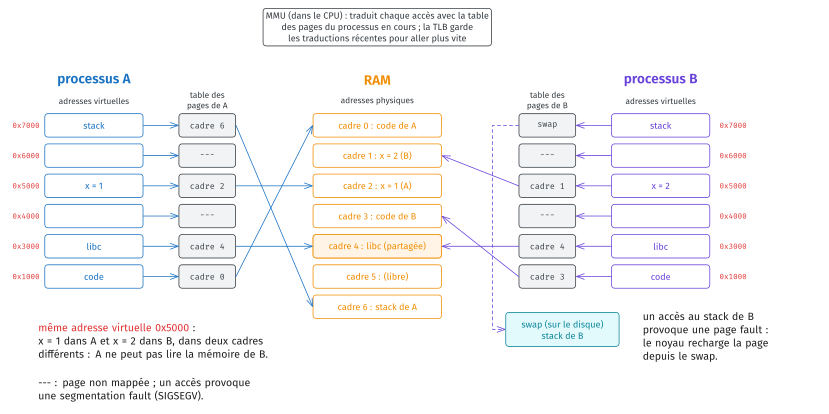
Deux processus, la même adresse virtuelle 0x5000, deux cadres différents en RAM.
Ce schéma illustre les avantages de la mémoire virtuelle :
isolation :
0x5000ne désigne pas le même cadre pour A et pour B ; A n’a aucun moyen d’atteindre le cadre 1 de B, puisqu’aucune entrée de sa table n’y mène ;partage : le code de la libc, identique pour tous, n’est chargé qu’une fois en RAM ;
swap : une page peut être sur le disque plutôt qu’en RAM.
Page fault
Si la table des pages n’indique pas de cadre pour la page demandée, ou si l’accès n’est pas autorisé (écriture dans une page en lecture seule), la MMU déclenche une faute de page (page fault) et le noyau prend la main. Trois cas :
la page appartient au processus, mais n’a pas encore été chargée (voir demand paging) : le noyau la charge, c’est normal et rapide ;
la page a été déplacée dans le swap : le noyau la relit depuis le disque, c’est normal mais lent ;
l’adresse n’appartient pas au processus (ou l’accès est interdit, par exemple une écriture dans une zone en lecture seule) : le noyau envoie au processus le signal
SIGSEGV(segmentation fault), qui le termine par défaut (les signaux seront vus dans la partie sur les processus).
Une page fault est donc souvent un événement normal, contrairement à une segmentation fault, qui signale un vrai problème d’accès mémoire dans le code.
Zones logiques et espace d’adressage d’un processus
Chaque processus possède son propre espace d’adressage virtuel, divisé en plusieurs zones de mémoire ou segments mémoire :
Text segment : code exécutable du programme, généralement en lecture seule pour éviter des modifications accidentelles ou malveillantes du code.
Rodata segment (read-only data segment) : données constantes du programme (littéraux de chaînes comme
"Hello world!", constantes, tables de constantes générées par le compilateur), en lecture seule.Data segment : variables globales et statiques initialisées.
BSS segment (Block Started by Symbol) : variables globales et statiques non initialisées ou initialisées à 0 (mises à zéro au démarrage du programme).
Stack (pile) : variables locales et contexte des appels de fonctions (voir Le stack pas à pas).
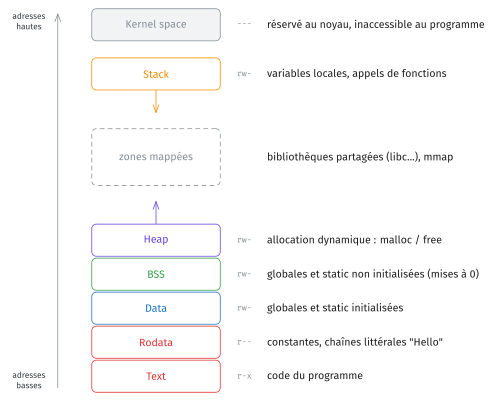
Le schéma simplifie : les zones mappées (créées par mmap : bibliothèques partagées comme la libc, fichiers projetés en mémoire, gros blocs alloués par malloc) sont regroupées en un seul bloc entre la heap et le stack.
Le kernel space, en haut, est réservé au noyau : il est présent dans l’espace d’adressage de chaque processus mais inaccessible depuis l’espace utilisateur.
Pour aller plus loin : autres zones
En plus des segments principaux, un processus peut aussi contenir :
Thread-Local Storage (TLS) : mémoire privée à chaque thread, utilisée pour stocker des variables propres au thread ;
I/O Memory : zones mappées pour la communication directe avec des périphériques.
Sous Linux x86-64, le kernel space occupe la moitié haute de l’espace d’adressage virtuel.
Le noyau appelle ces différentes zones des VMA (Virtual Memory Areas) : chaque ligne de /proc/PID/maps (voir ci-dessous) correspond à une VMA.
Où vit chaque variable ?
#include <stdio.h>
#include <stdlib.h>

int compteur = 1;  // data : globale initialisée
int total;         // BSS : globale non initialisée (mise à 0)

int main(void) {                      // le code de main : text
    static int nombre_appels = 0;     // BSS : static initialisée à 0
    int age = 20;                     // stack : variable locale
    char *message = "Bonjour";        // message : stack ; "Bonjour" : rodata
    int *notes = malloc(5 * sizeof *notes);  // notes : stack ; les 5 int : heap
    printf("%s %d %d %d %d\n", message, age, compteur, total, nombre_appels);
    free(notes);
    return 0;
}
Un pointeur est une variable comme une autre : notes est sur le stack (variable locale), la zone qu’il désigne est dans la heap.
En pratique : /proc/PID/maps
Le pseudo-système de fichiers /proc permet d’inspecter l’espace mémoire d’un processus.
La commande suivante affiche la cartographie mémoire du processus courant (ici cat : self désigne le processus qui lit le fichier ; pour un autre processus, remplacez self par son PID).
Sortie raccourcie (... : lignes retirées) :
$ cat /proc/self/maps
5b07fff55000-5b07fff57000 r--p 00000000 fc:01 11797247        /usr/bin/cat
5b07fff57000-5b07fff5b000 r-xp 00002000 fc:01 11797247        /usr/bin/cat
5b07fff5b000-5b07fff5d000 r--p 00006000 fc:01 11797247        /usr/bin/cat
5b07fff5d000-5b07fff5e000 r--p 00007000 fc:01 11797247        /usr/bin/cat
5b07fff5e000-5b07fff5f000 rw-p 00008000 fc:01 11797247        /usr/bin/cat
5b0814475000-5b0814496000 rw-p 00000000 00:00 0               [heap]
...
79f616000000-79f616028000 r--p 00000000 fc:01 11813669        /usr/lib/x86_64-linux-gnu/libc.so.6
79f616028000-79f6161bd000 r-xp 00028000 fc:01 11813669        /usr/lib/x86_64-linux-gnu/libc.so.6
...
7ffc7627f000-7ffc762a0000 rw-p 00000000 00:00 0               [stack]
...
Chaque ligne décrit une zone. Seules trois colonnes sont utiles ici : la plage d’adresses virtuelles, les droits et le nom.
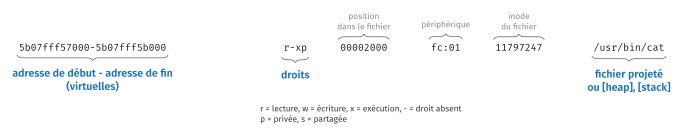
Les droits sont les mêmes lettres que pour les fichiers (voir partie fichiers), mais appliquées à des zones mémoire : r = lecture (read), w = écriture (write), x = exécution, - = droit absent ; la 4e lettre vaut p pour une zone privée (private, les modifications ne sont pas partagées avec les autres processus) ou s pour une zone partagée (shared).
En lisant les lignes de haut en bas (adresses croissantes) :
les lignes
/usr/bin/catcorrespondent à l’exécutable :r-xp(lecture et exécution) est le code (text),rw-p(lecture et écriture) contient data et BSS, les lignesr--pcontiennent rodata et des informations utilisées au chargement ;[heap]: zone d’allocation dynamique ;lignes avec
.so: bibliothèques partagées (ici la libc), dans les zones mappées ;[stack]: le stack du processus, aux adresses les plus hautes.
Les autres lignes ([vvar], [vdso], ld-linux, zones sans nom…) sont des zones techniques du système : on peut les ignorer.
Deux autres commandes donnent des informations proches :
pmap PIDaffiche la même cartographie que/proc/PID/maps, avec la taille de chaque zone ;size mon_programmeaffiche la taille des sectionstext,dataetbssd’un exécutable (sans le lancer).
Pour aller plus loin : sortie complète et format ELF
Sortie complète de la commande :
$ cat /proc/self/maps
5b07fff55000-5b07fff57000 r--p 00000000 fc:01 11797247                   /usr/bin/cat
5b07fff57000-5b07fff5b000 r-xp 00002000 fc:01 11797247                   /usr/bin/cat
5b07fff5b000-5b07fff5d000 r--p 00006000 fc:01 11797247                   /usr/bin/cat
5b07fff5d000-5b07fff5e000 r--p 00007000 fc:01 11797247                   /usr/bin/cat
5b07fff5e000-5b07fff5f000 rw-p 00008000 fc:01 11797247                   /usr/bin/cat
5b0814475000-5b0814496000 rw-p 00000000 00:00 0                          [heap]
79f615800000-79f615ff0000 r--p 00000000 fc:01 11799968                   /usr/lib/locale/locale-archive
79f616000000-79f616028000 r--p 00000000 fc:01 11813669                   /usr/lib/x86_64-linux-gnu/libc.so.6
79f616028000-79f6161bd000 r-xp 00028000 fc:01 11813669                   /usr/lib/x86_64-linux-gnu/libc.so.6
79f6161bd000-79f616215000 r--p 001bd000 fc:01 11813669                   /usr/lib/x86_64-linux-gnu/libc.so.6
79f616215000-79f616216000 ---p 00215000 fc:01 11813669                   /usr/lib/x86_64-linux-gnu/libc.so.6
79f616216000-79f61621a000 r--p 00215000 fc:01 11813669                   /usr/lib/x86_64-linux-gnu/libc.so.6
79f61621a000-79f61621c000 rw-p 00219000 fc:01 11813669                   /usr/lib/x86_64-linux-gnu/libc.so.6
79f61621c000-79f616229000 rw-p 00000000 00:00 0
79f61637d000-79f6163a2000 rw-p 00000000 00:00 0
79f6163b7000-79f6163b9000 rw-p 00000000 00:00 0
79f6163b9000-79f6163bb000 r--p 00000000 fc:01 11808014                   /usr/lib/x86_64-linux-gnu/ld-linux-x86-64.so.2
79f6163bb000-79f6163e5000 r-xp 00002000 fc:01 11808014                   /usr/lib/x86_64-linux-gnu/ld-linux-x86-64.so.2
79f6163e5000-79f6163f0000 r--p 0002c000 fc:01 11808014                   /usr/lib/x86_64-linux-gnu/ld-linux-x86-64.so.2
79f6163f1000-79f6163f3000 r--p 00037000 fc:01 11808014                   /usr/lib/x86_64-linux-gnu/ld-linux-x86-64.so.2
79f6163f3000-79f6163f5000 rw-p 00039000 fc:01 11808014                   /usr/lib/x86_64-linux-gnu/ld-linux-x86-64.so.2
7ffc7627f000-7ffc762a0000 rw-p 00000000 00:00 0                          [stack]
7ffc762ed000-7ffc762f1000 r--p 00000000 00:00 0                          [vvar]
7ffc762f1000-7ffc762f3000 r-xp 00000000 00:00 0                          [vdso]
ffffffffff600000-ffffffffff601000 --xp 00000000 00:00 0                  [vsyscall]
lignes de l’exécutable : 1re ligne
r--p(offset00000000) : en-têtes ELF et informations pour l’édition de liens dynamique ;r-xp: text ; 3e ligner--p(offset00006000) : rodata ; 4e ligner--p(offset00007000) : zone RELRO (tables de liens dynamiques remises en lecture seule après le chargement) ;rw-p: data et BSS ;locale-archive: fichier de données (paramètres régionaux) mappé en mémoire, pas une bibliothèque ;ld-linux-x86-64.so.2: le chargeur dynamique, qui charge les bibliothèques partagées au lancement ;lignes
rw-psans nom : zones anonymes (BSS des bibliothèques, gros blocsmalloccréés parmmap…) ;[vvar]: variables du noyau exposées en lecture seule (timers, horloge) ;[vdso]: bibliothèque spéciale du noyau pour certaines fonctions système rapides (ex.gettimeofdaysans appel système) ;[vsyscall]: ancien mécanisme de x86-64, maintenu pour compatibilité.
Sous Linux, les programmes sont généralement au format ELF (Executable and Linkable Format).
Ce format découpe le code et les données en sections (.text, .data, .bss, .rodata, etc.).
Au lancement, le chargeur (loader) ELF projette (mappe) en mémoire virtuelle des segments (décrits dans les program headers), qui regroupent des sections de mêmes droits. C’est ce qui explique la structure observée dans /proc/self/maps.
Exemples de sections ELF typiques :
.text→ le code exécutable.rodata→ données constantes en lecture seule (chaînes, tables).data→ variables globales/statiques initialisées.bss→ variables globales/statiques non initialisées.eh_frame→ informations pour remonter la pile d’appels (exceptions, debug).symtabet.strtab→ tables des symboles et des noms (utiles au debugger, non chargées en mémoire)
Optimisations matérielles et logicielles
TLB (Translation Lookaside Buffer)
Consulter la table des pages à chaque accès mémoire serait trop lent (la table est elle-même en RAM). La TLB est un petit cache de la MMU qui garde les traductions virtuel→physique récentes, comme un carnet des derniers numéros de téléphone composés, plus rapide à consulter que l’annuaire complet :
TLB hit : traduction trouvée dans la TLB, immédiate ;
TLB miss : consultation de la table des pages, plus lente.
Un programme qui accède à la mémoire de façon très dispersée provoque beaucoup de TLB miss et peut être fortement ralenti.
Demand paging (chargement à la demande)
Au lancement, ou après un malloc, Linux ne place pas toutes les pages en RAM : il les réserve seulement dans l’espace d’adressage virtuel.
Une page reçoit un cadre en RAM à son premier accès, grâce à une page fault (premier cas ci-dessus).
Le démarrage est plus rapide et la RAM n’est occupée que par les pages réellement utilisées, mais le premier accès à chaque page est plus lent.
Conséquence : la mémoire réservée par un processus (mémoire virtuelle, colonne VIRT de htop) peut être bien plus grande que la mémoire physique réellement utilisée (colonne RES).
Copy-On-Write (COW)
Lors d’un fork() (création d’un processus par copie d’un autre, voir la partie sur les processus), le noyau ne copie pas la mémoire : les deux processus partagent les mêmes cadres, marqués en lecture seule.
Une page n’est copiée que lorsque l’un des processus la modifie :
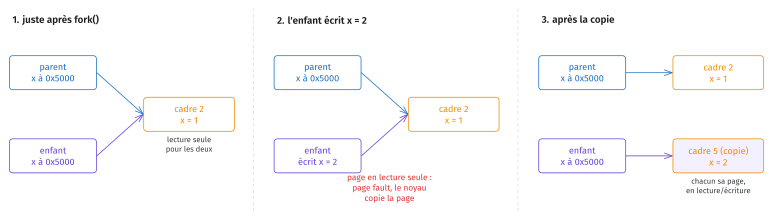
Cela évite les copies inutiles de grandes zones mémoire et accélère la création de processus.
Swap
Le swap est un espace disque (partition ou fichier) utilisé comme extension de la RAM. Lorsqu’il n’y a plus de place en mémoire physique, le noyau déplace certaines pages rarement utilisées vers le swap (deuxième cas de page fault ci-dessus). Cela permet d’exécuter plus de programmes simultanément, mais au prix de temps d’accès beaucoup plus lents (voir la hiérarchie mémoire).
Un usage excessif du swap (thrashing) ralentit fortement le système : il passe son temps à déplacer des pages entre la RAM et le disque.
Allocation mémoire
Il existe plusieurs manières pour un programme de demander de la mémoire au système :
Allocation statique : espace réservé à la compilation (variables globales et
static, dans le data segment ou le BSS segment), qui existe pendant toute l’exécution.Allocation automatique : sur le stack, pour les variables locales et les informations d’appel de fonction ; cette mémoire est libérée automatiquement en fin de bloc ou au retour de la fonction.
Allocation dynamique : dans la heap, via
malloc, calloc, realloc ; nécessite unfreemanuel (voir Gestion mémoire en C).
Le stack pas à pas
Le stack (pile d’appels) est la zone où chaque appel de fonction réserve la mémoire de ses variables locales. Prenons ce programme :
#include <stdio.h>
#include <stdlib.h>

int carre(int valeur) {
    int resultat = valeur * valeur;
    return resultat;
}

int calcul(int nombre) {
    int *tableau = malloc(3 * sizeof *tableau);
    if (tableau == NULL) {
        return -1;
    }
    int total = carre(nombre);
    // ... utilisation de tableau
    free(tableau);
    return total;
}

int main(void) {
    int reponse = calcul(4);
    printf("%d\n", reponse);
    return 0;
}
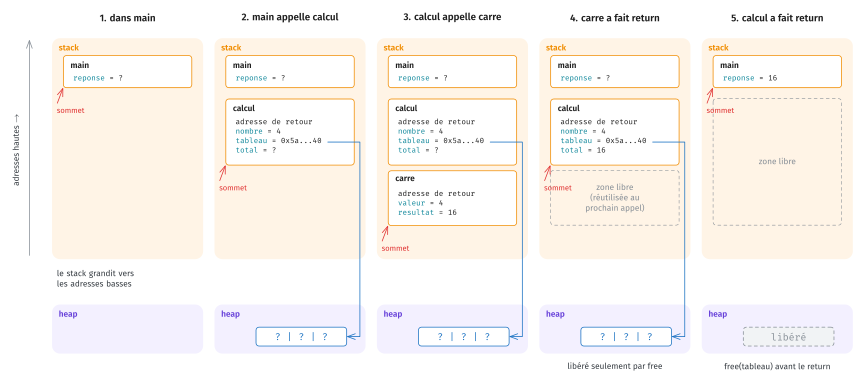
Le stack et la heap pendant l’exécution du programme : le stack grandit vers les adresses basses.
à chaque appel de fonction, une stack frame est empilée : elle contient, en haut, l”adresse de retour (l’endroit du code où reprendre à la fin de l’appel), puis les paramètres et les variables locales. C’est l’allocation automatique ;
quand
calculappellecarre, la stack frame decarreest empilée sous celle decalcul;au
returndecarre, sa stack frame est dépilée : sa mémoire est libérée automatiquement et sera réutilisée par le prochain appel ;le haut du stack correspond à nouveau à la stack frame de
calcul, qui reçoit la valeur renvoyée (total= 16) ;calcullibère le bloc de la heap avecfree, puis faitreturn: sa stack frame est dépilée à son tour etmainreçoit 16 dansreponse.
La dernière fonction appelée est la première terminée : c’est le principe LIFO (Last In, First Out). Ce fonctionnement est géré par le code que le compilateur ajoute au début et à la fin de chaque fonction ; le noyau se contente d’agrandir la zone du stack quand c’est nécessaire.
Le bloc alloué par malloc dans la heap, lui, n’est pas lié à une stack frame : il existe jusqu’au free, même après la fin de la fonction qui l’a alloué.
Pourquoi le stack est rapide
Empiler ou dépiler une stack frame revient à déplacer le sommet du stack (une adresse gardée dans un registre du processeur) : allouer sur le stack ne coûte presque rien.
malloc, au contraire, doit chercher un bloc libre de la bonne taille parmi ceux qu’il gère, et parfois demander de la mémoire au noyau ; free doit ensuite rendre ce bloc.
De plus, le haut du stack, utilisé en permanence, est presque toujours dans le cache L1.
Pourquoi le stack est limité
Il n’a besoin de stocker que les variables locales, les arguments et les adresses de retour : une petite taille suffit en général.
Il doit rester contigu : appeler une fonction et en sortir se fait simplement en déplaçant le sommet.
Il ne peut pas être déplacé s’il devient trop grand : les pointeurs vers des variables locales deviendraient invalides.
Sa taille maximale est donc fixée au lancement : 8 Mio par défaut (ulimit -s affiche 8192, en Kio).
Pour une zone mémoire plus grande, dont la seule limite est la mémoire disponible sur la machine, il faut utiliser la heap avec l’allocation dynamique.
Stack overflow
Le dépassement de la taille du stack (stack overflow) arrive typiquement avec une fonction récursive sans condition d’arrêt :
// fonction récursive sans condition de fin
void f(int n) {
    f(n + 1);
}

int main(void) {
    f(5);
    return 0;
}
Compilé sans optimisation (gcc -std=c2x -Wall -Wextra -pedantic -g test_stack_overflow.c -o test_stack_overflow), l’exécution affiche Erreur de segmentation (core dumped) : chaque appel empile une nouvelle stack frame, jusqu’à sortir de la zone du stack.
La mention core dumped signifie que le noyau a (éventuellement, selon la configuration du système) écrit une image mémoire du processus, un core dump, exploitable ensuite avec un debugger.
Avec -O2, gcc transforme cette récursion en boucle infinie : le programme tourne sans fin, sans planter.
valgrind ./test_stack_overflow donne plus d’informations (extrait) :
==43722== Stack overflow in thread #1: can't grow stack to 0x1ffe801000
==43722==    at 0x109135: f (test_stack_overflow.c:2)
==43722==  The main thread stack size used in this run was 8388608.
La taille indiquée (8 388 608 octets) correspond bien aux 8 Mio de ulimit -s.
La heap et mmap
malloc prend ses blocs dans la heap, qu’il agrandit au besoin vers les adresses hautes.
Avec la glibc, les gros blocs (128 Kio ou plus par défaut) sont pris ailleurs : malloc demande au noyau une zone dédiée avec l’appel système mmap, placée dans les zones mappées et rendue au système dès le free.
Pour aller plus loin : allocation alignée
posix_memalign et aligned_alloc allouent un bloc dont l’adresse est un multiple d’une valeur donnée (par exemple 64 octets) :
int posix_memalign(void **memptr, size_t alignment, size_t size);
void *aligned_alloc(size_t alignment, size_t size);
memptr: adresse du pointeur qui recevra l’adresse du bloc (posix_memalignseulement)alignment: alignement voulu en octets, une puissance de 2 (et un multiple desizeof(void *)pourposix_memalign)size: taille du bloc en octets (pouraligned_alloc, un multiple dealignmentpour rester portable)
posix_memalign retourne 0 en cas de succès, sinon un code d’erreur (errno n’est pas modifié).
aligned_alloc retourne l’adresse du bloc alloué, ou NULL en cas d’erreur (errno indique la cause).
Le bloc se libère avec free, comme un bloc alloué par malloc.
C’est utile pour les instructions SIMD (calcul sur plusieurs valeurs à la fois) et les entrées/sorties directes sur disque, qui exigent des adresses alignées.
Variables globales ou locales ?
Évitez d’utiliser des variables globales partout : préférez des variables locales, passées en paramètres.
En plus d’être plus lisible (on voit quelles fonctions utilisent quelles données), c’est souvent plus rapide dans un programme optimisé : le compilateur peut garder une variable locale dans un registre, alors qu’il doit écrire une globale en mémoire et la relire autour de chaque appel de fonction, qui pourrait la modifier.
Pour la heap, ce qui coûte surtout, ce sont les appels à malloc et free, pas l’accès aux données.
Pour aller plus loin : mesurer le temps d’accès
Le programme suivant incrémente dix milliards de fois quatre variables allouées différemment, puis la variable globale via un pointeur, et mesure le temps de chaque boucle avec clock (<time.h>) :
clock_t clock(void);
Retourne le temps CPU consommé par le programme, en ticks (type clock_t), ou (clock_t) -1 en cas d’erreur.
On divise par CLOCKS_PER_SEC pour obtenir des secondes. La valeur au lancement du programme n’est pas forcément 0 : seule la différence entre deux appels a un sens.
#include <stdio.h>
#include <stdlib.h>
#include <time.h>

#define N 10000000000UL

long global_variable = 0;

int main(void) {

    long stack_variable = 0;

    static long static_local = 0;

    long *dynamic_variable = malloc(sizeof(*dynamic_variable));
    if (dynamic_variable == NULL) {
        perror("malloc");
        return 1;
    }
    *dynamic_variable = 0;

    // pointeur vers la globale (accès indirect)
    long *global_pointer = &global_variable;

    printf("Adresses :\n");
    printf("Automatique (stack) : %p\n", (void *)&stack_variable);
    printf("Dynamique (heap)    : %p\n", (void *)dynamic_variable);
    printf("Statique locale     : %p\n", (void *)&static_local);
    printf("Globale             : %p\n", (void *)&global_variable);

    printf("Temps :\n");

    clock_t start;
    clock_t end;
    size_t i = 0;

    start = clock();
    for (i = 0; i < N; i++)
        stack_variable++;
    end = clock();
    printf("Automatique (stack) : %.3f sec\n",
           (double)(end - start) / CLOCKS_PER_SEC);

    start = clock();
    for (i = 0; i < N; i++)
        (*dynamic_variable)++;
    end = clock();
    printf("Dynamique (heap)    : %.3f sec\n",
           (double)(end - start) / CLOCKS_PER_SEC);

    start = clock();
    for (i = 0; i < N; i++)
        static_local++;
    end = clock();
    printf("Statique locale     : %.3f sec\n",
           (double)(end - start) / CLOCKS_PER_SEC);

    start = clock();
    for (i = 0; i < N; i++)
        global_variable++;
    end = clock();
    printf("Globale             : %.3f sec\n",
           (double)(end - start) / CLOCKS_PER_SEC);

    start = clock();
    for (i = 0; i < N; i++)
        (*global_pointer)++;
    end = clock();
    printf("Globale (pointeur)  : %.3f sec\n",
           (double)(end - start) / CLOCKS_PER_SEC);

    free(dynamic_variable);
    return 0;
}
Résultat à l’exécution, compilé sans optimisation (gcc -std=c2x -Wall -Wextra -pedantic -O0 test_acces.c -o test_acces) :
Adresses :
Automatique (stack) : 0x7ffebe9cfc58
Dynamique (heap)    : 0x5e1ee9f4d2a0
Statique locale     : 0x5e1eb2955020
Globale             : 0x5e1eb2955018
Temps :
Automatique (stack) : 8.683 sec
Dynamique (heap)    : 10.536 sec
Statique locale     : 38.297 sec
Globale             : 39.019 sec
Globale (pointeur)  : 10.422 sec
Les adresses sur le stack sont plus hautes (0x7...) que celles des autres segments.
La variable dynamique (heap) se trouve dans une zone distincte, à des adresses supérieures à celles des variables globale et statique.
Ces deux dernières, initialisées à 0, sont côte à côte dans le segment BSS.
Au niveau des performances :
à
-O0, les quatre boucles font la même chose : à chaque itération, la variable est lue en mémoire, incrémentée, puis réécrite en mémoire. Aucune n’est gardée dans un registre et toutes restent dans le cache L1 ;l’écart observé ne vient donc pas de la RAM, mais de la façon dont le processeur exécute ces instructions (adressage relatif au registre
rbppour la variable locale, relatif au compteur ordinalrippour les variables globale et statique, enchaînement écriture puis relecture de la même adresse). Il varie d’un processeur à l’autre et n’est pas garanti ;incrémentée via un pointeur (dernière boucle), la même globale est aussi rapide que la variable de la heap : c’est la façon d’accéder à la variable qui compte ici, pas la zone mémoire ;
avec
-O2, le compilateur supprime ou simplifie ces boucles (tous les temps valent0.000) : il suppose qu’aucune autre partie du programme ne modifie ces variables pendant la boucle, sauf si elles sont déclaréesvolatile(voir Autres mots-clés).
Ce benchmark ne montre donc pas directement l’effet de la zone mémoire : en code optimisé, ce sont les variables locales, gardées en registre, qui sont les plus rapides.
Fuites et erreurs mémoire
Une mauvaise gestion de la mémoire dans votre code peut entraîner des bugs difficiles à détecter et des comportements imprévisibles. Voici les principales catégories d’erreurs et comment les éviter.
Fuites mémoire
Memory leak (fuite mémoire) : se produit quand un bloc de mémoire alloué dynamiquement n’est jamais libéré. La mémoire reste occupée jusqu’à la fin du programme, ce qui peut épuiser les ressources disponibles.
#include <stdlib.h>

void fonction(void) {
    int *ptr = malloc(sizeof(int) * 100);
    // ... utilisation de ptr
    // Oubli du free(ptr); → fuite mémoire !
}

int main(void) {
    for (int i = 0; i < 1000000; i++) {
        fonction();  // À chaque itération, 400 octets sont perdus
    }
    return 0;
}
Conséquences : augmentation progressive de la consommation mémoire, ralentissement du système, crash par manque de mémoire.
Solution : appeler free() une fois pour chaque bloc alloué par malloc() ou calloc(). Après un realloc() réussi, c’est le pointeur renvoyé par realloc() qu’il faut libérer (l’ancien bloc est déjà libéré).
Erreurs d’accès mémoire
En C, rien ne vérifie qu’un indice est dans les limites d’un tableau : une écriture hors limites modifie simplement la mémoire voisine.
Dans la heap, un bloc est entouré des métadonnées de l’allocateur (informations utilisées par malloc et free, comme la taille du bloc) et d’autres blocs :
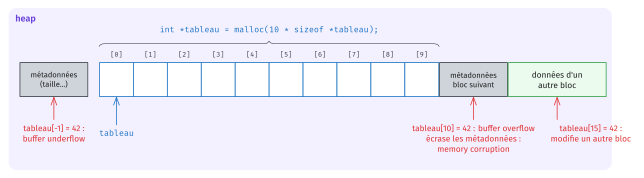
Buffer overflow : écriture au-delà de la fin d’un tableau.
int *tableau = malloc(10 * sizeof(int));
tableau[15] = 42;  // Erreur ! Écriture hors limites
free(tableau);
Buffer underflow : écriture avant le début d’un tableau.
int *tableau = malloc(10 * sizeof(int));
tableau[-1] = 42;  // Erreur ! Écriture avant le début
free(tableau);
Memory corruption : écrasement des métadonnées de l’allocateur. L’erreur n’apparaît souvent que plus tard, au
freeou aumallocsuivant :int *tableau = malloc(10 * sizeof(int)); // Écriture bien au-delà des limites for (int i = 0; i < 1000; i++) { tableau[i] = i; // Peut corrompre les structures internes } free(tableau); // Crash ou comportement imprévisible
Invalid read/write : accès à une zone mémoire non allouée ou non accessible.
int *ptr = NULL;
*ptr = 42;  // Erreur ! Déréférencement d'un pointeur NULL

int tableau[5];
int valeur = tableau[100];  // Lecture hors limites
NULL pointer dereference : déréférencement d’un pointeur
NULL(premier exemple ci-dessus), qui provoque immédiatement une segmentation fault : la page de l’adresse 0 n’est jamais mappée.
Conséquences : corruption de données, crash avec segmentation fault, comportement imprévisible, failles de sécurité exploitables. Un débordement ne plante pas forcément : tant que l’adresse reste dans une page du processus, la MMU ne voit rien d’anormal.
Erreurs liées à la libération
Use-after-free : utilisation d’un pointeur après avoir libéré la mémoire qu’il référence.
int *ptr = malloc(sizeof(int));
*ptr = 42;
free(ptr);

printf("%d\n", *ptr);  // Erreur ! La mémoire a été libérée
*ptr = 10;             // Erreur ! Écriture dans une zone libérée
Double free : double libération d’une même zone mémoire.
int *ptr = malloc(sizeof(int));
free(ptr);
free(ptr);  // Erreur ! Corruption de l'allocateur
Conséquences : corruption des métadonnées de l’allocateur, crash du programme, failles de sécurité graves.
Solution : mettre le pointeur à NULL après chaque free() :
free(ptr);
ptr = NULL;  // un free(NULL) ne fait rien et *ptr plante immédiatement
Cela ne protège que ce pointeur : les éventuelles copies pointent toujours vers la zone libérée (voir dangling pointer ci-dessous).
Dangling pointer (pointeur pendant) : un pointeur qui référence une zone mémoire invalide (libérée ou hors de portée).
int *ptr1 = malloc(sizeof *ptr1);
*ptr1 = 42;
int *ptr2 = ptr1;  // ptr2 pointe vers la même zone
free(ptr1);
ptr1 = NULL;
// ptr2 est maintenant un dangling pointer
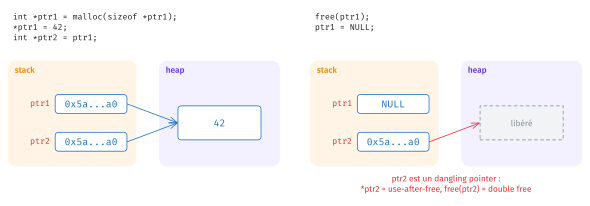
Une variable locale dont on retourne l’adresse donne aussi un dangling pointer : sa stack frame est dépilée au return (voir Le stack pas à pas).
#include <stdio.h>

int *creer_pointeur(void) {
    int variable_locale = 42;
    return &variable_locale;  // Erreur ! variable_locale n'existe plus après le return
}

int main(void) {
    int *ptr = creer_pointeur();
    printf("%d\n", *ptr);  // Comportement indéfini
    return 0;
}
Ici, gcc émet l’avertissement -Wreturn-local-addr et remplace l’adresse retournée par NULL : le programme plante systématiquement avec une segmentation fault au lieu d’afficher 42 ou une valeur aléatoire.
Erreurs de concurrence
Data race : accès simultanés non synchronisés à une même zone mémoire par plusieurs threads, avec au moins une écriture. Le résultat devient imprévisible. Les threads et les solutions (mutex…) seront vus dans la partie sur les threads.
Outils de détection
Deux outils principaux détectent ces erreurs à l’exécution :
Valgrind (outil Memcheck) exécute le programme dans un processeur simulé qui surveille chaque accès mémoire : aucune recompilation (compilez seulement avec
-gpour avoir les numéros de ligne), mais une exécution beaucoup plus lente ;valgrind --leak-check=full ./mon_programme
AddressSanitizer (ASan) ajoute des vérifications au programme à la compilation : plus rapide que Valgrind, il nécessite de recompiler.
gcc -fsanitize=address -g mon_programme.c -o mon_programme
./mon_programme
Erreur |
Valgrind |
ASan |
|---|---|---|
fuite mémoire |
oui |
oui |
débordement d’un bloc de la heap |
oui |
oui |
débordement d’un tableau local (stack) |
non |
oui |
use-after-free, double free |
oui |
oui |
lecture d’une valeur non initialisée |
oui |
non |
⚠️ Ne lancez pas Valgrind sur un programme compilé avec -fsanitize : les deux outils ne fonctionnent pas ensemble.
Deux autres sanitizers complètent ASan :
UndefinedBehaviorSanitizer (UBSan) détecte les comportements indéfinis (dépassement d’entier signé, décalage invalide…), souvent combiné avec ASan :
-fsanitize=address,undefined;ThreadSanitizer (TSan,
-fsanitize=thread) détecte les data races (voir la partie sur les threads).
Bonnes pratiques
Toujours libérer la mémoire allouée : chaque bloc alloué doit avoir son
free().Mettre les pointeurs à
NULLaprès libération :ptr = NULL;aprèsfree(ptr).Vérifier les retours de
malloc():malloc()peut retournerNULLen cas d’échec.Utiliser des outils de détection : Valgrind, ASan pendant le développement.
Initialiser les pointeurs :
int *ptr = NULL;plutôt queint *ptr;.Respecter les limites des tableaux : toujours vérifier les indices.
Documenter la propriété de la mémoire : qui est responsable du
free()?Activer les warnings du compilateur :
-Wall -Wextra -pedantic(éventuellement-Werrorpour transformer les avertissements en erreurs).
Exemple de code sûr :
#include <stdio.h>
#include <stdlib.h>

int main(void) {
    // calloc initialise la zone à zéro
    int *tableau = calloc(10, sizeof *tableau);
    if (tableau == NULL) {
        perror("calloc");
        return 1;
    }

    for (size_t i = 0; i < 10; i++) {
        tableau[i] = (int)i * 2;
    }

    free(tableau);
    tableau = NULL;  // un accès à *tableau provoquerait directement une segmentation fault
    return 0;
}