Partie 5 - Threads
Compilez avec le flag -pthread :
gcc -std=c2x -Wall -Wextra -pedantic -g -pthread prog.c
Pour détecter les data races, utilisez l’outil helgrind de valgrind (voir la page Outils) :
valgrind --tool=helgrind ./a.out
Erreurs de compilation fréquentes :
implicit declaration of function 'gettid': ajoutez#define _GNU_SOURCEavant le premier#include;implicit declaration of function 'nanosleep'(ourand_r,clock_gettime) : ces fonctions sont POSIX, pas du C standard.-pthreadles rend en général visibles, mais mettez quand même#define _POSIX_C_SOURCE 200809Lavant le premier#include: c’est une bonne pratique (voir la note du cours) ;passing argument 3 of 'pthread_create' from incompatible pointer type: la fonction du thread doit avoir exactement la signaturevoid *ma_fonction(void *arg).
Les fonctions pthread retournent leur code d’erreur au lieu de modifier errno (voir le cours).
Pour alléger vos programmes, vous pouvez utiliser cette fonction :
// affiche le message d'erreur et quitte si err != 0 (fonctions pthread)
void verifier_pthread(int err, const char *message) {
    if (err != 0) {
        fprintf(stderr, "%s: %s\n", message, strerror(err)); // <string.h>
        exit(EXIT_FAILURE);
    }
}

// utilisation :
verifier_pthread(pthread_create(&tid, NULL, ma_fonction, &args), "pthread_create");
Quelques fonctions utiles pour cette partie :
conversion d’une chaîne de caractères (par exemple
argv[1]) en entier :#include <stdlib.h> int atoi(const char *nptr); long atol(const char *nptr); long long atoll(const char *nptr); // mettre NULL pour endptr et 10 pour base (base décimale) unsigned long strtoul(const char *nptr, char **endptr, int base); unsigned long long strtoull(const char *nptr, char **endptr, int base);
entiers de taille fixe de
<stdint.h>:int64_t(signé sur 64 bits) etuint64_t(non signé sur 64 bits, de 0 à 264 - 1) ; pour les afficher avecprintf: les macros de<inttypes.h>donnent le bon format,PRIu64pour unuint64_tetPRId64pour unint64_t#include <inttypes.h> uint64_t n = 42; printf("n = %" PRIu64 "\n", n); // la chaîne est collée à la macro
la commande shell
timemesure la durée d’exécution d’un programme (time ./a.out) et affiche trois valeurs :real: le temps réellement écoulé (celui d’un chronomètre)user: le temps CPU passé dans le programme, cumulé sur tous les cœurs (avec 8 threads qui calculent en parallèle,userpeut valoir 8 foisreal)sys: le temps CPU passé dans le noyau (appels système)
gettid()(<unistd.h>) retourne le TID du thread appelant, il faut ajouter#define _GNU_SOURCEen première ligne du fichier (voir le cours)
p5e1 - Premier thread & passage de paramètres
Écrivez un programme qui :
définit une structure
Args { int valeur; const char *message; }crée un thread qui affiche
messageetvaleurainsi que le PID (getpid()) et le TID (gettid())le thread retourne
NULLle
mainaffiche son PID et son TID avant de créer le thread, puis de nouveau après lepthread_join
Pensez à tester le retour de pthread_create et pthread_join : ces fonctions ne modifient pas errno mais retournent le code d’erreur, affichez-le avec strerror (et non perror).
La fonction du thread se donne à pthread_create par son nom, sans parenthèses, et l’adresse de la structure est passée dans le dernier paramètre (void *) : voir le rappel du cours.
Résultat attendu :
$ gcc -std=c2x -Wall -Wextra -pedantic -g -pthread p5/p5e1.c && ./a.out
[main   PID: 3995757 - TID: 3995757] création du thread...
[thread PID: 3995757 - TID: 3995758] valeur : 5, message : coucou
[main   PID: 3995757 - TID: 3995757] thread terminé
p5e2 - Valeur de retour
Écrivez un programme qui demande à un thread de calculer la somme de 1 à N dans une boucle (uint64_t n = 6000000000, incluez <stdint.h>) et de retourner la valeur.
N est passé au thread par son argument void * (adresse d’une variable ou d’une structure).
Pour retourner un uint64_t, le thread l’alloue avec malloc et retourne le pointeur, que le main récupère avec pthread_join puis libère (voir Retourner une valeur).
Le compteur de la boucle doit lui aussi être un uint64_t : un int ne peut pas dépasser environ 2,1·109, bien moins que N.
Note
La somme de 1 à N vaut N(N+1)/2. Pour qu’elle tienne dans un uint64_t (maximum 264 - 1 ≈ 1,8·1019), il faut N ≤ 6 074 000 999.
Au-delà, le calcul déborde (dépassement de capacité) et le résultat affiché est faux (il est calculé modulo 264).
Résultat attendu :
$ gcc -std=c2x -Wall -Wextra -pedantic -g -pthread p5/p5e2.c && time ./a.out
[main] Somme de 1 à 6000000000 = 18000000003000000000

real    0m20,704s
user    0m20,699s
sys     0m0,003s
Le temps de calcul varie selon la machine (de quelques secondes à quelques dizaines de secondes).
p5e3 - Parallélisation de la somme
Écrivez un programme qui prend en argument de la ligne de commande (argv[1], converti avec strtoull) un nombre de threads nb_threads.
Par défaut, 4 threads. Si le nombre vaut 0, affichez une erreur : c’est aussi ce que renvoie strtoull pour une chaîne non numérique.
uint64_t nb_threads = 4;
if (argc == 2) {
    nb_threads = strtoull(argv[1], NULL, 10);
}
Ces threads se répartissent le calcul de la somme de 1 à N (uint64_t n = 6000000000).
Chaque thread retourne sa somme partielle, que le main additionne.
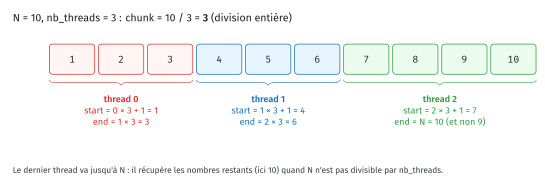
Chaque thread calcule la somme partielle sur un intervalle [start, end] (bornes incluses) qui lui est donné par le main : les intervalles se suivent et ont tous la même taille, sauf celui du dernier thread, qui va jusqu’à N (il récupère les éléments restants si la division ne tombe pas juste).
Chaque thread affiche son intervalle au début de son calcul, puis sa somme partielle à la fin.
Aide : répartition des bornes
Exemple avec N = 10 et 3 threads :
Procédez par étapes :
Créez les
nb_threadsthreads dans une boucle, en donnant à chacun sa propre structure (start,end, rang), par exemple un tableau de structures dont on passe&args[i](ne passez pas&i, voir Créer N threads dans une boucle). Pour l’instant, chaque thread affiche seulement son intervalle ; vérifiez les bornes avec un petit N (par exemple 10).Chaque thread calcule sa somme partielle et la transmet au
main: avecmalloccomme dans p5e2, ou dans un champ de sa structure comme dans l’exemple du cours. Lemainfait lespthread_joindans une deuxième boucle et additionne.Remettez N à 6 000 000 000 et mesurez.
Testez avec plusieurs valeurs de nb_threads (1, 2, 4, 8, puis le nombre de cœurs de votre machine, affiché par la commande nproc, et le double) et regardez le temps d’exécution avec time.
Comment évoluent real et user quand on ajoute des threads ?
Que se passe-t-il au-delà du nombre de cœurs ?
Résultat attendu (l’ordre des lignes varie d’une exécution à l’autre) :
$ gcc -std=c2x -Wall -Wextra -pedantic -g -pthread p5/p5e3.c && time ./a.out 8
[main] N=6000000000 nb_threads=8
[thread 0] calcul de 1 à 750000000
[thread 3] calcul de 2250000001 à 3000000000
[thread 1] calcul de 750000001 à 1500000000
[thread 2] calcul de 1500000001 à 2250000000
[thread 5] calcul de 3750000001 à 4500000000
[thread 6] calcul de 4500000001 à 5250000000
[thread 4] calcul de 3000000001 à 3750000000
[thread 7] calcul de 5250000001 à 6000000000
[thread 7] résultat = 4218750000375000000
[thread 2] résultat = 1406250000375000000
[thread 3] résultat = 1968750000375000000
[thread 1] résultat = 843750000375000000
[thread 4] résultat = 2531250000375000000
[thread 0] résultat = 281250000375000000
[thread 5] résultat = 3093750000375000000
[thread 6] résultat = 3656250000375000000
[main] Somme parallèle (8 threads) = 18000000003000000000

real    0m2,877s
user    0m19,557s
sys     0m0,006s
p5e4 - N threads et ordonnancement non déterministe
Écrivez un programme C qui crée nb_threads threads.
Le nombre de threads et la graine du générateur aléatoire peuvent être passés en arguments de la ligne de commande, dans cet ordre (./a.out nb_threads seed).
Par défaut, 4 threads seront créés et la graine sera le nombre de secondes écoulées depuis 1970 (time(NULL)).
N’oubliez pas d’initialiser le générateur avec srand(seed) avant de tirer les durées avec rand().
C’est le main qui tire la durée de chaque thread (rand n’est pas prévue pour être appelée depuis plusieurs threads, voir p5e8) et la lui transmet avec son rang (dans une structure).
Le programme principal affiche son PID (getpid()), son TID (gettid()) et ses paramètres (nombre de threads et graine aléatoire, seed).
À chaque thread seront donnés un rang (dans [0, nb_threads-1]) et un temps de « travail » entre 1 et 5 secondes, qu’il passera à attendre avec la fonction sleep :
#include <unistd.h>

// endort le thread appelant pendant seconds secondes
unsigned int sleep(unsigned int seconds);
Chaque thread affiche des informations sur lui-même :
rang
PID du processus
TID du thread
durée de travail
Puis il effectue son « travail » (avec sleep) et finit par afficher qu’il a terminé sa tâche.
Résultat attendu (l’ordre des lignes peut varier, en particulier entre threads de même durée) :
$ gcc -std=c2x -Wall -Wextra -pedantic -g -pthread p5/p5e4.c && ./a.out 6 0
Thread principal - PID: 3996839 - TID: 3996839 - nb_threads: 6 - seed: 0
thread 0 (PID: 3996839 - TID: 3996840) va travailler 4 s
thread 3 (PID: 3996839 - TID: 3996843) va travailler 1 s
thread 1 (PID: 3996839 - TID: 3996841) va travailler 2 s
thread 2 (PID: 3996839 - TID: 3996842) va travailler 3 s
thread 5 (PID: 3996839 - TID: 3996845) va travailler 1 s
thread 4 (PID: 3996839 - TID: 3996844) va travailler 4 s
thread 3 (PID: 3996839 - TID: 3996843) a terminé ses 1 s de travail
thread 5 (PID: 3996839 - TID: 3996845) a terminé ses 1 s de travail
thread 1 (PID: 3996839 - TID: 3996841) a terminé ses 2 s de travail
thread 2 (PID: 3996839 - TID: 3996842) a terminé ses 3 s de travail
thread 0 (PID: 3996839 - TID: 3996840) a terminé ses 4 s de travail
thread 4 (PID: 3996839 - TID: 3996844) a terminé ses 4 s de travail
p5e5 - Data race volontaire : compteur global sans protection
Créez 4 threads qui incrémentent 1 000 000 fois chacun une variable globale. Affichez le compteur à la fin.
Quelle devrait être la valeur du compteur ? Comparez-la à la valeur affichée : pourquoi ce décalage ? (voir la section « Pourquoi ce bug ? » du cours)
Testez avec valgrind --tool=helgrind ./a.out.
Sous Valgrind, les threads sont exécutés un par un : le résultat affiché sera donc souvent correct, mais l’outil signalera la data race (Possible data race).
Que comprenez-vous du message d’erreur ?
Aide : lire la sortie de helgrind
La sortie est longue ; les lignes utiles ressemblent à ceci (les lignes by 0x... qui suivent viennent de la bibliothèque pthread et peuvent être ignorées) :
Possible data race during read of size 4 at 0x10C014 by thread #3
Locks held: none
   at 0x1091BE: incremente (p5e5.c:9)

This conflicts with a previous write of size 4 by thread #2
Locks held: none
   at 0x1091C7: incremente (p5e5.c:9)
 Address 0x10c014 is 0 bytes inside data symbol "compteur"
read of size 4 ... by thread #3: le thread n° 3 lit 4 octets (unint) ;This conflicts with a previous write ... by thread #2: le thread n° 2 avait écrit au même endroit ;Locks held: none: aucun des deux threads ne détenait de mutex à ce moment ;incremente (p5e5.c:9): la fonction et la ligne du code concernées ;data symbol "compteur": la variable partagée en cause.
Remarque : une data race est un comportement indéfini (UB, Undefined Behavior) en C ; les résultats peuvent donc varier, et parfois être « corrects », par exemple avec -O2 qui transforme la boucle (voir le cours).
p5e6 - Atomic : rendre le compteur correct
Reprenez p5e5 mais utilisez un atomic_int (incluez <stdatomic.h>) pour protéger la modification.
Testez avec valgrind --tool=helgrind ./a.out : le compteur doit valoir 4 000 000 et helgrind ne doit plus signaler d’erreur (ERROR SUMMARY: 0 errors).
p5e7 - Mutex : rendre le compteur correct
Reprenez p5e5 mais protégez l’incrément avec un mutex.
Testez avec valgrind --tool=helgrind ./a.out : même résultat attendu que pour p5e6.
Sous helgrind, ce programme est lent (environ 30 secondes pour 4 000 000 lock/unlock) : patientez, ou réduisez temporairement le nombre d’incréments.
Que se passe-t-il si vous verrouillez le mutex une seule fois autour de toute la boucle, plutôt qu’autour de compteur++ ?
Le résultat est-il correct ? Les threads travaillent-ils encore en parallèle ?
p5e8 - Pattern producteur/consommateur
En partant de l”exemple du cours sur les variables de condition, proposez un programme qui utilise deux threads : un producteur qui va mettre des entiers dans un tableau et un consommateur qui va les lire et les afficher.
Contrairement à l’exemple du cours, il faut ici deux variables de condition (non_plein et non_vide) ; comme dans le cours, chaque attente se fait dans une boucle while qui reteste la condition.
Vous aurez besoin de :
une taille de tableau
TAILLE(à déclarer avec un#define)un tableau d”
intde tailleTAILLEun compteur d’éléments dans le tableau (
count = 0)un index en écriture pour savoir dans quelle case le producteur va ensuite écrire (
idx_in = 0)un index en lecture pour savoir dans quelle case le consommateur va ensuite lire (
idx_out = 0)un mutex
une variable de condition
non_pleinpour signaler que le tableau n’est pas pleinune variable de condition
non_videpour signaler que le tableau n’est pas vide
Aide : le tableau circulaire
Les deux index avancent de case en case et reviennent à 0 après la dernière case : le tableau est utilisé « en anneau ».
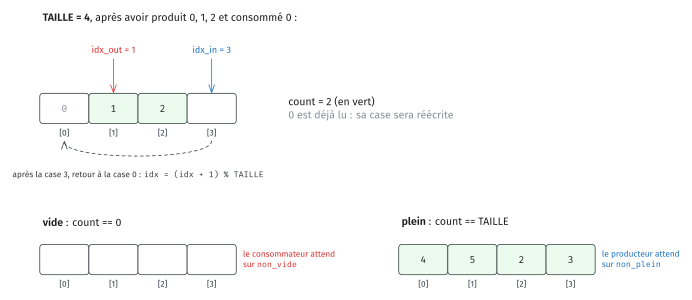
Dans une boucle infinie, le producteur écrit les entiers 0, 1, 2… dans le tableau et affiche "[producteur] produit %d (count=%d)\n" ; le consommateur les lit et affiche "[consommateur] consomme %d (count=%d)\n".
Quelques indices :
quelles variables sont partagées entre les deux threads ? Elles ne doivent être lues ou modifiées que mutex verrouillé ;
sur quelle condition chaque thread doit-il attendre, et sur quelle variable de condition ?
après avoir écrit un élément, qui faut-il réveiller ? Et après en avoir lu un ?
les deux index reviennent à 0 après la dernière case (voir l’aide sur le tableau circulaire) ;
une fois le mutex relâché, chaque thread dort un peu : le producteur entre 50 et 150 millisecondes (
dort_aleatoire(&seed, 50, 150);), le consommateur entre 200 et 400 millisecondes (dort_aleatoire(&seed, 200, 400);).
Le producteur est plus rapide que le consommateur : le tableau va se remplir, et le producteur devra attendre sur non_plein.
Pour dormir, utilisez la fonction suivante. nanosleep et rand_r sont des fonctions POSIX, pas du C standard : mettez #define _POSIX_C_SOURCE 200809L en première ligne du fichier (-pthread les rend en général déjà visibles, mais c’est une bonne pratique, voir la note du cours) :
#define _POSIX_C_SOURCE 200809L // en première ligne, pour nanosleep et rand_r
#include <stdlib.h>
#include <time.h>

// endort le thread appelant entre min_ms et max_ms millisecondes
// seed : graine propre au thread (rand_r, contrairement à rand, peut être
// utilisée par plusieurs threads)
void dort_aleatoire(unsigned int *seed, long min_ms, long max_ms) {
    long ms = min_ms + rand_r(seed) % (max_ms - min_ms + 1);
    struct timespec duree = {.tv_sec = ms / 1000,
                             .tv_nsec = (ms % 1000) * 1000000L};
    nanosleep(&duree, NULL);
}
Chaque thread déclare sa propre graine au début de sa fonction, avec une valeur différente pour les deux threads (sinon, lancés dans la même seconde, ils tireraient les mêmes durées) :
unsigned int seed = (unsigned int)time(NULL);         // dans le producteur
unsigned int seed = (unsigned int)time(NULL) ^ 12345; // dans le consommateur
Procédez par étapes :
Avec
#define TAILLE 1:countne vaut que 0 ou 1, et producteur et consommateur alternent strictement.Avec
#define TAILLE 4: si les index sont bien calculés moduloTAILLE, rien d’autre ne change.countmonte jusqu’à 4, puis le producteur attend que le consommateur libère une case.Que se passe-t-il si un thread dort avant de relâcher le mutex ?
Le programme tourne indéfiniment : arrêtez-le avec Ctrl+C.
Résultat attendu avec TAILLE = 4 (début ; l’ordre et les valeurs de count varient d’une exécution à l’autre) :
$ gcc -std=c2x -Wall -Wextra -pedantic -g -pthread p5/p5e8.c && ./a.out
[producteur] produit 0 (count=1)
[consommateur] consomme 0 (count=0)
[producteur] produit 1 (count=1)
[producteur] produit 2 (count=2)
[consommateur] consomme 1 (count=1)
[producteur] produit 3 (count=2)
[producteur] produit 4 (count=3)
[consommateur] consomme 2 (count=2)
[producteur] produit 5 (count=3)
[producteur] produit 6 (count=4)
[consommateur] consomme 3 (count=3)
[producteur] produit 7 (count=4)
[consommateur] consomme 4 (count=3)
[producteur] produit 8 (count=4)
^C
p5e9 - Somme parallèle d’un grand tableau
Créez un main qui prend en arguments de la ligne de commande, dans cet ordre :
deux bornes minimum et maximum (
int64_t r_min;int64_t r_max;, conversion avecatoll), avecr_min <= r_maxetr_max - r_min < RAND_MAX(pour querand() % (r_max - r_min + 1)puisse atteindre toutes les valeurs de l’intervalle ; afficher une erreur sinon)une graine du générateur aléatoire (seed,
unsigned int rand_seed;, conversion avecatoi)une taille de tableau (
uint64_t taille;, conversion avecstrtoull)un nombre de threads (
uint64_t nb_threads;, conversion avecstrtoull, erreur si 0)
Ensuite, le main :
alloue dynamiquement le tableau de taille
taillepuis le remplit avec des valeurs aléatoires dans[r_min, r_max](rand() % (r_max - r_min + 1) + r_min)crée
nb_threadsthreads, où chacun somme un segment du tableau[start, end[(endexclu, contrairement à p5e3 : c’est la convention habituelle pour des indices de tableau, qui vont de0àtailleexclu) et retourne sa somme (par exemple, t0 calcule de 0 à 10000, t1 de 10000 à 20000, etc. ; si la division ne tombe pas juste, le dernier thread prend les cases restantes)
Le main additionne les sommes partielles et affiche le résultat et le temps de calcul (création des threads, calcul et join).
Pour mesurer le temps, n’utilisez pas clock() : elle mesure le temps CPU cumulé de tous les threads (comme user avec time), qui ne diminue pas quand on ajoute des threads.
Utilisez clock_gettime avec CLOCK_MONOTONIC, qui donne le temps réel écoulé (fonction POSIX : ajoutez #define _POSIX_C_SOURCE 200809L en première ligne du fichier, comme pour p5e8 ; struct timespec contient des secondes, tv_sec, et des nanosecondes, tv_nsec) :
#include <time.h>

struct timespec debut, fin;
clock_gettime(CLOCK_MONOTONIC, &debut);
// ... calcul ...
clock_gettime(CLOCK_MONOTONIC, &fin);
double duree = (fin.tv_sec - debut.tv_sec) + (fin.tv_nsec - debut.tv_nsec) / 1e9;
Résultat attendu (le temps dépend de la machine) :
$ gcc -std=c2x -Wall -Wextra -pedantic -g -pthread p5/p5e9.c && ./a.out -10 10 1 1000000 4
Somme = -1413
Temps de remplissage : 0.029 s
Temps de calcul (4 threads) : 0.001 s
Testez différents paramètres (avec des tailles de tableau beaucoup plus grandes, en surveillant la mémoire : 8 octets par case, par exemple 100 000 000 cases occupent 800 Mo) et mesurez le gain de temps en faisant varier le nombre de threads.
Mesurez aussi le temps de remplissage du tableau et comparez-le au temps de la somme : quelle partie du programme est la plus longue ? Le gain obtenu avec les threads est-il aussi important que dans p5e3 ?