Partie 4 - Processus
Support présentationQu’est-ce qu’un processus ?
Un processus est une instance d’un programme en cours d’exécution.
Un même programme peut donc avoir plusieurs exécutions simultanées.
Par analogie avec la programmation objet : le programme joue le rôle de la classe (Voiture) et chaque processus celui d’une instance (ma_voiture_rouge, ma_voiture_bleue…).
Un processus est une unité gérée par le système d’exploitation, qui s’intercale entre les processus et le matériel :
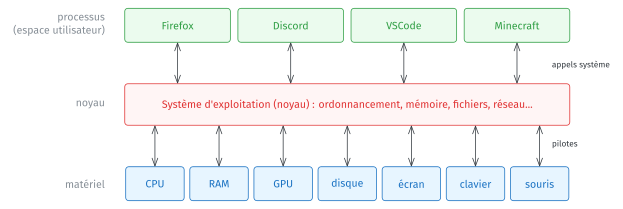
Chaque processus dispose de ses propres ressources :
une zone mémoire privée (code, données, stack, heap…, voir mémoire)
un PID (Process ID) : identifiant unique du processus
un PPID (Parent PID) : identifiant du processus parent
un UID (User ID) : utilisateur propriétaire
des descripteurs de fichiers (liaisons avec fichiers, entrées/sorties, sockets…, voir Descripteurs de fichiers)
un contexte d’exécution (program counter, registres CPU, état)
Le program counter (compteur ordinal) est le registre du CPU qui contient l’adresse de la prochaine instruction à exécuter : il indique où en est le processus dans son code.
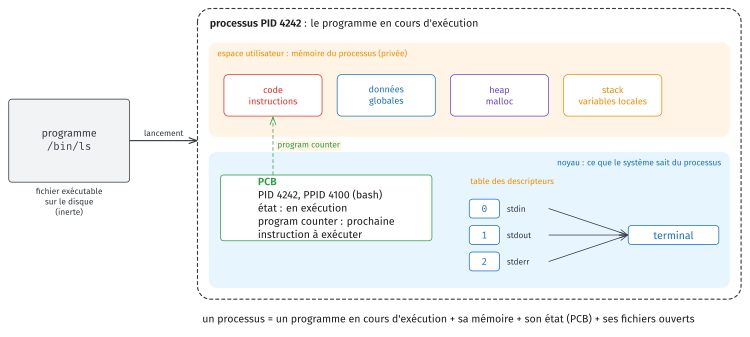
Un processus = un programme en cours d’exécution + sa mémoire + son état (PCB) + ses fichiers ouverts.
Toutes ces informations sont regroupées dans une structure noyau appelée PCB (Process Control Block). Le noyau tient une table des processus : pour chaque processus, une entrée qui mène à son PCB.
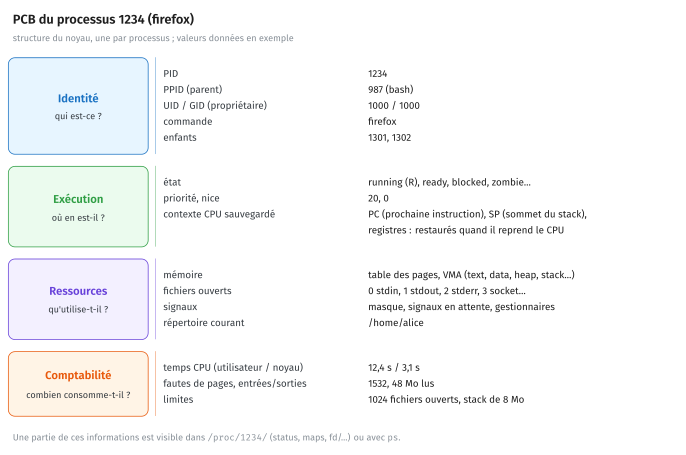
Un processus peut engendrer d’autres processus (processus enfants), formant une arborescence.
On peut l’afficher avec pstree (-p pour afficher les PID) :
pstree -p
Le processus initial lancé au démarrage (PID 1) est souvent nommé init ou systemd.
Il adopte les processus orphelins (sauf si un autre processus subreaper, souvent systemd --user, s’en charge) et supervise de nombreux services (fichiers, périphériques, réseau, etc.).
La commande ps permet d’afficher les processus, par défaut uniquement ceux de l’utilisateur rattachés au terminal courant :
$ # & lance la commande en arrière-plan, fg permet de la récupérer ensuite
$ sleep 10 &
[1] 3816906

$ ps
    PID TTY          TIME CMD
3812988 pts/2    00:00:00 bash
3816906 pts/2    00:00:00 sleep
3817006 pts/2    00:00:00 ps
Différentes options permettent d’afficher plus d’informations comme a pour aussi voir les processus lancés par les autres utilisateurs, u pour un affichage détaillé (utilisateur, %CPU, %MEM…) ou x pour montrer les processus qui n’ont pas de terminal de contrôle :
$ ps aux
USER         PID %CPU %MEM    VSZ   RSS TTY      STAT START   TIME COMMAND
root           1  0.0  0.0 168072 11744 ?        Ss   13:17   0:02 /sbin/init splash
root           2  0.0  0.0      0     0 ?        S    13:17   0:00 [kthreadd]
root           3  0.0  0.0      0     0 ?        S    13:17   0:00 [pool_workqueue_release]
...
La colonne STAT donne l’état du processus (voir le cycle de vie ci-dessous) :
Lettre |
Signification |
|---|---|
|
en exécution ou prêt à s’exécuter (running) |
|
endormi : bloqué en attente d’un événement (sleeping) |
|
stoppé (Ctrl+Z, |
|
zombie : terminé, mais pas encore récupéré par son parent |
|
(après la lettre) processus au premier plan du terminal, par exemple |
Les autres caractères (s, I, <…) sont décrits dans man ps.
Dans un même terminal, une seule commande (un job, qui peut regrouper plusieurs processus comme ls | grep x) peut tourner à la fois au premier plan (foreground), pendant que d’autres peuvent tourner en arrière-plan (background).
Pour lancer un programme en arrière-plan, comme vu ci-dessus, ajoutez un & après la commande :
$ # gedit ouvre l'éditeur dans une fenêtre (sinon, remplacez par un autre programme graphique comme xeyes, ou par sleep 30)
$ gedit fichier.txt
$ # en fermant la fenêtre on reprend la main sur le terminal
$ # en ajoutant & :
$ gedit fichier.txt &
[1] 200404
$ # gedit s'ouvre en arrière-plan et le terminal est toujours accessible
$ # le 200404 est le PID du processus lancé avec gedit
Cycle de vie d’un processus
Au cours de son exécution, un processus passe par plusieurs états :
Nouveau (new) : créé par
forket chargé en mémoire ; l’ordonnanceur (scheduler) le fait ensuite passer à l’état prêt (ready)Prêt (ready) : en attente d’être ordonnancé
Exécution (running) : le processus utilise le CPU
Bloqué (blocked) : en attente d’un événement (I/O, signal). Il repasse en état prêt quand l’événement survient
Stoppé (stopped) : suspension volontaire/forcée par un
SIGSTOPou un debuggerZombie : terminé mais non récupéré par son parent (via
waitouwaitpid)Terminé (terminated) : effacé de la table des processus
Un signal (SIGSTOP, SIGKILL…) est un message envoyé à un processus par le noyau, par un autre processus ou depuis le clavier : les signaux sont présentés plus loin.
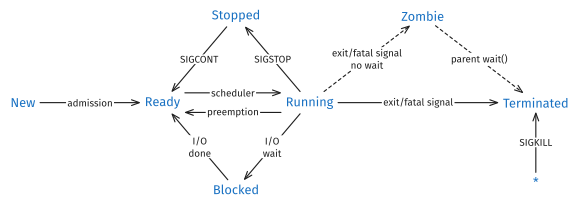
Un processus peut aussi être tué par le noyau, par exemple en cas d’accès mémoire invalide (SIGSEGV, le segmentation fault) ou de division entière par zéro (SIGFPE).
Pour aller plus loin : autres arrêts par le noyau et fermeture de session
Un processus peut aussi être interrompu par le noyau :
OOM Killer (Out-Of-Memory Killer) : si le système manque de mémoire (RAM + swap), le noyau Linux peut tuer avec un signal
SIGKILLun ou plusieurs processus pour libérer de la mémoire (en priorité celui qui occupe le plus de mémoire)Limites d’exécution : temps CPU, fichiers ouverts, etc.
Autres erreurs critiques :
SIGILL: instruction invalideSIGBUS: erreur de bus (ex. accès mal aligné sur certaines architectures)
Lorsqu’un utilisateur ferme son terminal ou sa session, ses processus reçoivent SIGHUP et sont en général tués, sauf s’ils ont été détachés (nohup, screen, tmux).
À l’extinction de la machine, tous les processus sont arrêtés.
Création de processus : fork
Ce que fait fork
Un processus est créé par fork() (<unistd.h>), qui duplique le processus qui l’appelle : le processus d’origine est le parent, la copie est l”enfant.
pid_t fork(void);
Retourne deux fois, une fois dans chaque processus : le PID de l’enfant dans le parent, et 0 dans l”enfant.
En cas d’erreur, retourne -1 dans le parent, et l’enfant n’est pas créé (errno indique la cause).
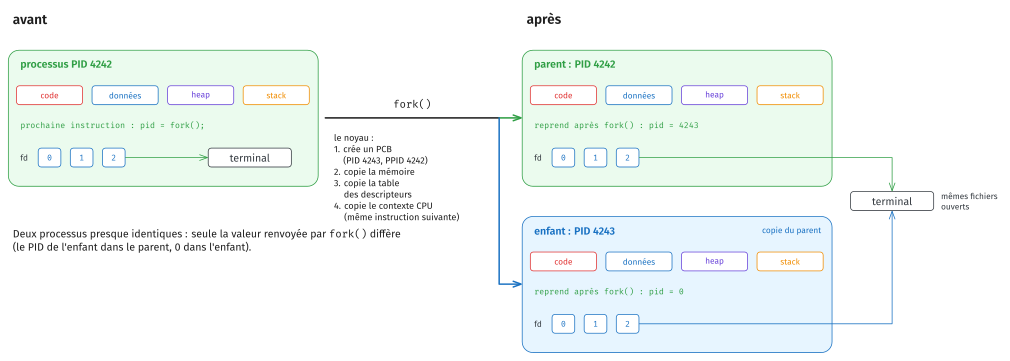
Au moment du fork, le noyau :
crée un nouveau PCB : l’enfant a son propre PID, et son PPID est le PID du parent ;
copie la mémoire du parent (code, variables globales, heap, stack) ;
copie la table des descripteurs de fichiers (voir plus bas) ;
copie le contexte CPU, dont le program counter : l’enfant reprend donc juste après l’appel à
fork, comme le parent.
L’enfant ne repart pas du début de main, comme le ferait un deuxième lancement du programme : c’est une copie du parent à l’instant du fork, avec les mêmes valeurs de variables et la même position dans le code.
La seule différence entre les deux processus est la valeur retournée par fork : c’est elle qui permet à chaque processus de savoir s’il est le parent ou l’enfant.
Chaque processus peut aussi demander son PID et celui de son parent (<unistd.h>) :
pid_t getpid(void);
pid_t getppid(void);
getpid retourne le PID du processus appelant, getppid celui de son parent.
Ces deux fonctions n’échouent jamais.
La fonction wait() permet au parent d’attendre la fin d’exécution de l’enfant avant de terminer le programme (wait(NULL) : on ne récupère pas le statut de fin de l’enfant, voir wait).
 1#define _POSIX_C_SOURCE 200809L
 2#include <stdio.h>
 3#include <stdlib.h>
 4#include <sys/types.h>
 5#include <sys/wait.h>
 6#include <unistd.h>
 7
 8int main(void) {
 9    // Création d'un processus enfant
10    pid_t pid = fork();
11
12    // À partir d'ici
13    // le code est exécuté à la fois par le parent et par l'enfant
14
15    if (pid == -1) {
16        // fork retourne -1 s'il y a eu un problème avec la création du
17        // processus enfant
18        perror("fork");
19        exit(EXIT_FAILURE);
20    }
21
22    if (pid == 0) {
23        // le processus enfant est identifiable par fork qui retourne 0
24        printf("(enfant) PID = %d, PPID = %d\n", getpid(), getppid());
25        // dans l'enfant : _exit (après avoir vidé le tampon de stdout)
26        fflush(stdout);
27        _exit(0);
28    } else {
29        // le processus parent reçoit de fork le PID du processus enfant
30        printf("(parent) PID = %d, Enfant = %d\n", getpid(), pid);
31
32        // Attente de la fin du processus enfant
33        // (NULL : on ne récupère pas son statut de fin, voir wait plus bas)
34        wait(NULL);
35    }
36
37    return 0;
38}
(enfant) PID = 49195, PPID = 49194
(parent) PID = 49194, Enfant = 49195
Deux exécutions du même code
Après le fork, le même code continue dans les deux processus, à partir de la même ligne.
Comme pid n’a pas la même valeur, le test if (pid == 0) ne donne pas le même résultat : chaque processus exécute une des deux branches du if, et le code placé après le if/else est exécuté par les deux.
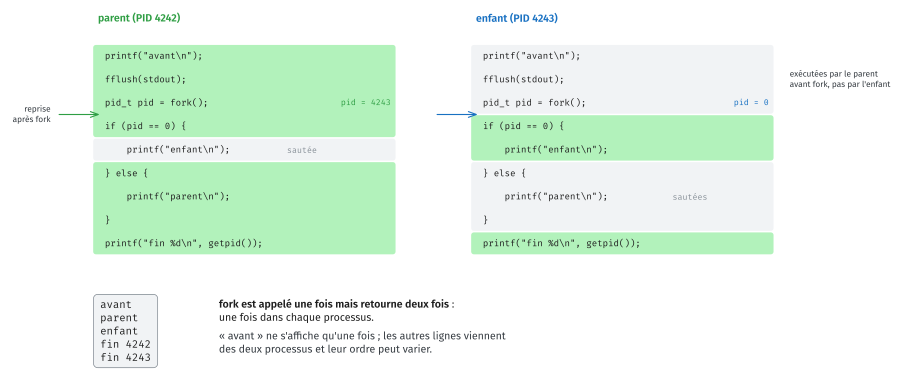
fork est appelé une fois mais retourne deux fois : une fois dans chaque processus.
Parent et enfant s’exécutent en parallèle (sur deux cœurs différents, ou à tour de rôle sur le même cœur, voir l’ordonnanceur) : l’ordre des lignes affichées peut varier d’une exécution à l’autre.
Mémoire copiée
Après le fork, le parent et l’enfant sont des copies indépendantes.
L’enfant reçoit une copie virtuelle exacte de l’espace mémoire du parent (heap, stack, variables globales…).
Voir l’exemple suivant, où l’enfant modifie la variable après le fork :
 1#define _POSIX_C_SOURCE 200809L
 2#include <stdio.h>
 3#include <stdlib.h>
 4#include <sys/types.h>
 5#include <sys/wait.h>
 6#include <unistd.h>
 7
 8int main(void) {
 9
10    int ma_variable = 4;
11
12    pid_t pid = fork();
13    if (pid == -1) {
14        perror("fork");
15        exit(EXIT_FAILURE);
16    }
17
18    if (pid == 0) {
19        // l'enfant modifie sa copie de la variable
20        ma_variable = 2;
21        printf("enfant : ma_variable = %d (adresse = %p)\n",
22               ma_variable,
23               (void *)&ma_variable);
24        // dans l'enfant : _exit (après avoir vidé le tampon de stdout)
25        fflush(stdout);
26        _exit(0);
27    } else {
28        // le parent attend la fin de l'enfant avant d'afficher
29        // (l'ordre des affichages est ainsi garanti)
30        wait(NULL);
31        printf("parent : ma_variable = %d (adresse = %p)\n",
32               ma_variable,
33               (void *)&ma_variable);
34    }
35
36    return 0;
37}
enfant : ma_variable = 2 (adresse = 0x7ffd5fab6b80)
parent : ma_variable = 4 (adresse = 0x7ffd5fab6b80)
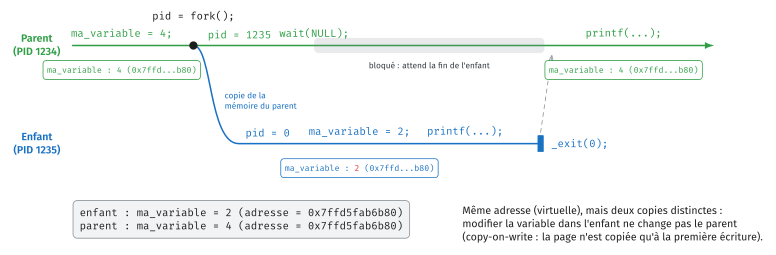
Déroulé du programme : la ligne du parent se ramifie au fork, chaque processus continue avec sa propre copie de ma_variable.
L’adresse affichée est identique, mais les valeurs diffèrent : c’est une adresse virtuelle, et chaque processus a sa propre table des pages, qui traduit cette adresse vers une page physique différente (voir la pagination).
Pour éviter de tout copier au moment du fork, les pages sont d’abord partagées en lecture seule, puis copiées seulement quand l’un des deux processus les modifie : c’est le Copy-On-Write (voir le schéma du chapitre Mémoire).
Ici, le wait du parent garantit l’ordre des affichages.
Descripteurs de fichiers copiés
fork copie aussi la table des descripteurs (voir Descripteurs de fichiers).
Les deux tables désignent les mêmes fichiers ouverts : le parent et l’enfant écrivent sur le même terminal, et s’ils lisent un même fichier, ils partagent la même position courante.
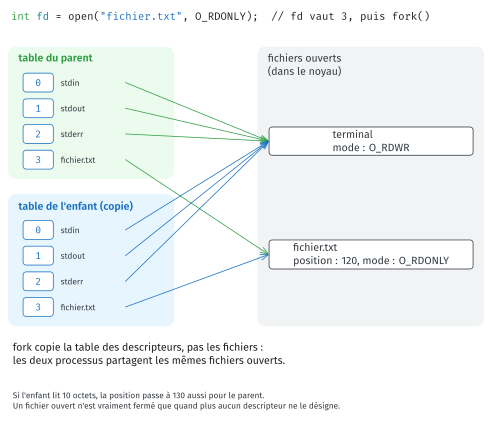
Ce partage est la base des pipes : un pipe (tube en français) créé avant le fork est accessible par le parent et par l’enfant.
Buffers et fork
Important
Règle à appliquer :
avant
fork:fflush(stdout);dans l’enfant, avant
_exit:fflush(stdout).
printf n’écrit pas directement : le texte est d’abord stocké dans le buffer (tampon en français) de stdout, dans la mémoire du processus (voir Sorties et Bufferisation).
Sans ces fflush, un texte encore dans le buffer au moment du fork est copié dans l’enfant et peut être affiché deux fois ; et un texte affiché par l’enfant peut être perdu, car _exit (voir plus bas) ne vide pas les buffers.
Pour aller plus loin : pourquoi le texte n’est pas toujours affiché deux fois
Le buffer de stdout est vidé à chaque \n quand la sortie est un terminal (bufferisation par ligne), mais seulement quand il est plein ou à la fin du programme quand la sortie est redirigée vers un fichier ou un pipe (./a.out > f, ./a.out | cat : bufferisation par bloc).
Avec printf("A\n"); fork(); sans fflush, puis un exit (ou un return du main) dans les deux processus :
dans un terminal,
Aest déjà parti au\n: il s’affiche une fois ;avec
./a.out | cat,Aest encore dans le buffer au moment dufork: les deux processus le vident à leur fin, etAs’affiche deux fois.
Le même programme se comporte donc différemment selon l’endroit où va sa sortie, d’où la règle ci-dessus.
Synchronisation parent / enfant : wait
En général, il vaut mieux qu’un parent attende la terminaison de ses enfants avant de se terminer lui-même.
L’appel à wait ou waitpid (<sys/wait.h>, man 2 wait) permet au parent d’attendre l’enfant :
pid_t wait(int *status);
pid_t waitpid(pid_t pid, int *status, int options);
pid(waitpid) : PID de l’enfant à attendre, ou-1pour n’importe quel enfantstatus: adresse d’un entier où sera enregistré le compte rendu de terminaison de l’enfant (ouNULLsi on ne s’y intéresse pas)options(waitpid) :0pour attendre en bloquant, ouWNOHANGpour retourner immédiatement si aucun enfant n’est terminé
wait attend la fin de n’importe quel enfant, comme waitpid(-1, &status, 0).
Retourne le PID de l’enfant terminé, ou -1 en cas d’erreur (errno indique la cause, ECHILD s’il n’y a plus d’enfant à attendre).
Avec WNOHANG, waitpid retourne 0 si des enfants existent mais qu’aucun n’est terminé.
Le compte rendu status ne s’utilise pas directement : on l’interroge avec des macros de <sys/wait.h> :
int WIFEXITED(int status);
int WEXITSTATUS(int status);
int WIFSIGNALED(int status);
int WTERMSIG(int status);
status: l’entier rempli parwaitouwaitpid(passé par valeur, sans&)
WIFEXITED (W = wait, if exited) est vrai (non nul) si l’enfant s’est terminé normalement, par un return dans main, exit ou _exit ; WEXITSTATUS donne alors son code de retour (de 0 à 255).
WIFSIGNALED (if signaled) est vrai si l’enfant a été tué par un signal ; WTERMSIG donne alors le numéro de ce signal.
Ce sont des macros et non des fonctions : les signatures indiquent seulement le type attendu et le type du résultat.
WEXITSTATUS et WTERMSIG n’ont de sens que si la macro de test correspondante est vraie.
Exemple :
int status;
if (wait(&status) == -1) {
    perror("wait");
    exit(EXIT_FAILURE);
}

if (WIFEXITED(status)) {
    printf("Code retour = %d\n", WEXITSTATUS(status));
} else if (WIFSIGNALED(status)) {
    printf("Tué par signal %d\n", WTERMSIG(status));
}
waitpid permet de cibler un enfant en particulier :
waitpid(pid, &status, 0);
ou de récupérer un enfant terminé s’il y en a un, sans bloquer :
waitpid(-1, &status, WNOHANG);
On passe &status car une fonction C ne retourne qu’une valeur : pour obtenir un deuxième résultat (ici le compte rendu, en plus du PID), on lui donne l’adresse d’une variable où l’écrire (voir Passage par valeur, passage par adresse).
Remplacement d’un processus : exec
La famille exec* remplace le programme du processus courant (code, données, stack, heap) par un nouveau programme.
Le PID reste identique : exec ne crée pas de processus, il change le programme exécuté par le processus courant.
Pour lancer un autre programme tout en continuant le sien, on combine fork et exec (voir plus bas).
Exemple :
#define _POSIX_C_SOURCE 200809L
#include <stdio.h>
#include <unistd.h>

int main(void) {

    // lance la commande ls située dans /bin/ls avec l'argument -l
    execl("/bin/ls", "ls", "-l", NULL);

    // si exec fonctionne sans problème, cette ligne n'est jamais atteinte
    // si exec échoue (execl retourne -1), affiche l'erreur correspondante
    perror("execl");
    return 1;
}
Le premier argument est le fichier à exécuter ; les suivants forment le tableau argv que recevra le main du nouveau programme (voir la fonction main au chapitre 1) :
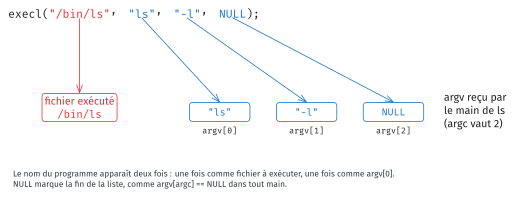
Le nom du programme apparaît donc deux fois (chemin du fichier, puis argv[0]), et la liste se termine toujours par NULL.
Variantes de exec
Toutes les fonctions exec* (<unistd.h>) remplacent le programme du processus courant.
La différence porte sur la manière de passer les arguments, et sur la recherche du programme dans le PATH :
int execl(const char *pathname, const char *arg, ... /*, (char *) NULL */);
int execlp(const char *file, const char *arg, ... /*, (char *) NULL */);
int execv(const char *pathname, char *const argv[]);
int execvp(const char *file, char *const argv[]);
pathname: chemin du fichier à exécuter ("/bin/ls")file: nom du programme, cherché dans les répertoires duPATH("ls")arg, ...: les arguments du nouveau programme, un par paramètre (argv[0],argv[1]…), terminés parNULLargv: les mêmes arguments, dans un tableau terminé parNULL
Ne retourne pas en cas de succès, puisque le programme appelant est remplacé.
Retourne -1 en cas d’erreur (errno indique la cause).
Le même appel avec chacune des quatre variantes :
arguments en liste ( |
arguments dans un tableau ( |
|
|---|---|---|
chemin complet |
|
|
recherche dans le |
|
|
avec, pour les versions v :
char *args[] = {"ls", "-l", NULL};
Résumé mnémotechnique, d’après le suffixe (les lettres placées après exec) :
l→ liste d’arguments ;v→ vecteur (tableauargv[]) ;p→ recherche du programme dans lePATH; sinon, il faut donner le chemin complet ;e→ un dernier argument donne les variables d’environnement du nouveau programme (execle,execve) ; sinon, il garde l’environnement courant.
Pour aller plus loin : execle, execve, execvpe et fexecve
Ces variantes prennent en plus les variables d’environnement du nouveau programme (suffixe e) :
int execle(const char *pathname, const char *arg, ...
           /*, (char *) NULL, char *const envp[] */);
int execve(const char *pathname, char *const argv[], char *const envp[]);
int execvpe(const char *file, char *const argv[], char *const envp[]);
int fexecve(int fd, char *const argv[], char *const envp[]);
pathname,file,arg, ...,argv: comme pourexecl,execlp,execvetexecvpenvp: variables d’environnement du nouveau programme, des chaînes"NOM=valeur"dans un tableau terminé parNULLfd(fexecve) : descripteur d’un fichier exécutable déjà ouvert
Ne retourne pas en cas de succès ; retourne -1 en cas d’erreur (errno indique la cause).
execle: commeexecl, mais permet de fournir un environnement spécifique.char *env[] = {"MYVAR=123", NULL}; execle("/usr/bin/env", "env", NULL, env);
execve: version système de base (toutes les autres s’appuient dessus), qui demande explicitement arguments + environnement.char *args[] = {"env", NULL}; char *env[] = {"MYVAR=hello", NULL}; execve("/usr/bin/env", args, env);
execvpe(GNU/Linux uniquement, nécessite#define _GNU_SOURCEavant les#include) : commeexecvp, mais permet aussi de passer un environnement spécifique.char *args[] = {"env", NULL}; char *env[] = {"MYVAR=from_execvpe", NULL}; execvpe("env", args, env);
fexecve(nécessite#define _POSIX_C_SOURCE 200809Lavant les#include, et#include <fcntl.h>pouropen) : lance un programme à partir d’un descripteur de fichier ouvert (fd). Pratique pour exécuter un binaire déjà ouvert, sans dépendre de son chemin.int fd = open("/bin/ls", O_RDONLY); char *args[] = {"ls", "-l", NULL}; char *env[] = {NULL}; fexecve(fd, args, env);
Usage classique : fork + exec pour lancer un autre programme dans un enfant :
pid_t pid = fork();
if (pid == 0) {
    execl("/bin/date", "date", NULL);
    perror("execl");
    _exit(1);
}
exit ou _exit ?
Un processus peut se terminer avec exit (<stdlib.h>, libc), qui vide d’abord les buffers de la libc (printf, fprintf…), ou avec _exit (<unistd.h>, appel système) :
void _exit(int status);
status: code de retour du processus, que le parent lit avecWEXITSTATUS
Termine le processus immédiatement, sans vider les buffers de la libc. Ne retourne jamais.
Dans l”enfant, on utilise _exit(), en particulier après un exec* raté : l’enfant a reçu une copie des buffers du parent, et exit() les viderait une deuxième fois.
Si l’enfant a lui-même affiché avec printf, il fait fflush(stdout) avant _exit() (voir buffers et fork).
Dans le parent (ou dans un programme sans fork), on utilise exit() (ou return dans main).
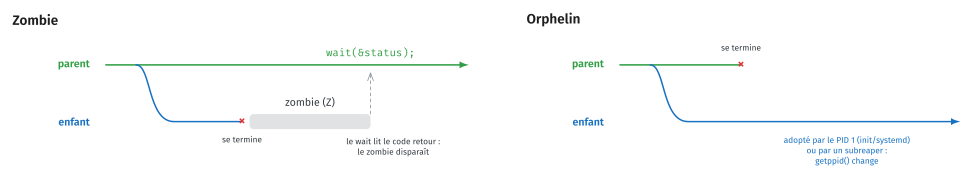
Zombies et orphelins
Zombie : processus terminé dont le parent n’a pas encore lu le code retour.
visible dans
psavec l’étatZdisparaît dès que le parent fait
wait, ou quand le parent se termine (il est alors adopté puis récupéré parinitou le subreaper)
Orphelin : processus dont le parent est mort → adopté par
init(PID 1) ou par un processus subreaper (sur un poste de travail, souventsystemd --user). Son PPID change donc :getppid()ne retourne plus le PID du parent d’origine.
Ordonnanceur et priorités
Une machine exécute en général beaucoup plus de processus qu’elle n’a de cœurs.
L”ordonnanceur (scheduler) du noyau partage les cœurs entre les processus prêts : chacun reçoit à tour de rôle une courte tranche de temps (quelques millisecondes), puis le noyau sauvegarde son contexte dans son PCB et donne le cœur à un autre processus (changement de contexte).
Un processus bloqué (en attente d’une lecture, d’un wait…) ne reçoit pas de temps CPU.
C’est l’ordonnanceur qui décide quel processus s’exécute, et à quel moment : c’est pourquoi l’ordre d’exécution du parent et de l’enfant n’est pas prévisible.
Un processus peut s’endormir volontairement (il est alors bloqué) pendant une durée donnée avec sleep (<unistd.h>) :
unsigned int sleep(unsigned int seconds);
seconds: durée de l’attente, en secondes (un nombre entier :sleep(0.1)est converti ensleep(0)et n’attend pas)
Met le processus en sommeil pendant seconds secondes, ou jusqu’à l’arrivée d’un signal intercepté (voir les signaux).
Retourne 0 si la durée s’est écoulée, sinon le nombre de secondes restantes (l’attente a été interrompue par un signal).
Nice et priorité utilisateur
Chaque processus possède une valeur de niceness (gentillesse) qui influence sa priorité CPU :
Plage de
-20(très prioritaire) à+19(très gentil, peu prioritaire).Plus la valeur est basse, plus le processus reçoit de CPU.
Exemples :
# Lancer un programme avec une priorité plus faible (nice=10)
nice -n 10 ./long_calcul

# Modifier la priorité d'un processus existant
# (une valeur négative, donc plus prioritaire, nécessite les droits root)
sudo renice -5 -p <pid>
Afficher la priorité et la valeur nice avec ps :
$ ps -o pid,comm,pri,ni -p <pid>
PID  COMMAND   PRI  NI
4242 mon_prog   19   0
PRI : priorité interne du noyau (calculée à partir de NI)
NI : valeur nice visible/utilisateur
Pour aller plus loin : politiques d’ordonnancement et limites de ressources
Politiques d’ordonnancement
Les politiques définissent comment le CPU est partagé :
SCHED_OTHER(CFS – Completely Fair Scheduler, remplacé par EEVDF – Earliest Eligible Virtual Deadline First depuis Linux 6.6) : politique par défaut, temps partagé équitable entre tous les processus. C’est avec cette politique que la valeurnices’applique.SCHED_FIFO(First In First Out) : temps réel, priorité stricte, les processus tournent tant qu’ils ne bloquent pas volontairement (pas de préemption par un autre FIFO de même priorité).SCHED_RR(Round Robin) : temps réel, similaire à FIFO mais avec un quantum de temps fixe par processus.
On peut visualiser/choisir la politique d’un processus avec la commande chrt :
# Afficher la politique et la priorité du processus
chrt -p <pid>

# Lancer un processus en temps réel round-robin avec priorité 20
sudo chrt -r 20 ./mon_prog
Un processus SCHED_FIFO de priorité élevée qui ne bloque jamais peut monopoliser un CPU et bloquer tout le reste (la valeur nice n’a aucun effet en temps réel) → à utiliser avec prudence !
Limites de ressources
En plus de la priorité, Linux permet de fixer des limites par processus, via ulimit (bash) ou setrlimit (fonction POSIX, en C).
ulimit -a    # afficher toutes les limites
ulimit -t 5  # limiter le temps CPU à 5 secondes
ulimit -n 64 # limiter le nombre de fichiers ouverts à 64
Ces limites évitent qu’un processus consomme toutes les ressources du système (ex. boucle infinie, fuite mémoire).
Outils d’observation
ps -o pid,ppid,stat,cmd -p <pid>: état du processustop/htop: charge CPU/mémoire en temps réelpstree -p: hiérarchie parent/enfantstrace -f ./prog: trace des appels système/proc/<pid>/: informations détaillées sur le processus
Note
Exploration pratique : le répertoire /proc
Sous Linux, chaque processus dispose d’un dossier dans le pseudo-système de fichiers /proc :
/proc/<pid>/contient des fichiers représentant l’état et les ressources du processus./proc/self/est un raccourci vers le dossier du processus courant.
Exemples :
$ echo $$                 # Affiche le PID du shell courant
12345

$ ls /proc/$$             # Liste les fichiers associés à ce processus (extrait)
attr  cmdline  cwd  environ  fd  maps  mem  mounts  status  task  ...

$ cat /proc/$$/cmdline; echo   # Commande ayant lancé ce processus (arguments séparés par des \0, sans \n final)
bash

$ grep -E '^(Name|State|Pid|PPid)' /proc/$$/status
Name:   bash
State:  S (sleeping)
Pid:    12345
PPid:   678
Quelques fichiers utiles :
cmdline: commande ayant lancé le processusstatus: informations détaillées (UID, état, mémoire, etc.)fd/: descripteurs de fichiers ouvertsmaps: mappage mémoire du processus
Ce mécanisme montre que le noyau expose les processus comme des fichiers, ce qui permet de les interroger avec les outils habituels sur les fichiers (cat, grep), sans appel système spécifique.
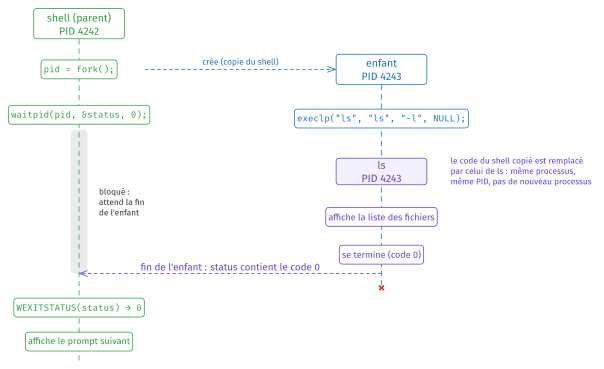
Résumé pratique : modèle fork → exec → wait
Schéma classique pour lancer un nouveau programme, utilisé par le shell pour chaque commande :
le parent fait
forkl’enfant fait
execle parent fait
wait
 1#define _POSIX_C_SOURCE 200809L
 2#include <stdio.h>
 3#include <stdlib.h>
 4#include <unistd.h>
 5#include <sys/wait.h>
 6
 7int main(void) {
 8    pid_t pid = fork();
 9    if (pid < 0) { perror("fork"); exit(EXIT_FAILURE); }
10
11    if (pid == 0) {
12        execl("/bin/ls", "ls", "-l", NULL);
13        perror("execl");
14        _exit(1);
15    } else {
16        int status = 0;
17        if (waitpid(pid, &status, 0) == -1) {
18            perror("waitpid");
19            exit(EXIT_FAILURE);
20        }
21        if (WIFEXITED(status))
22            printf("Code retour = %d\n", WEXITSTATUS(status));
23    }
24}
Vérifiez toujours la valeur de retour des appels système (fork, exec, waitpid, open…). En cas d’échec, utilisez perror() pour afficher un message clair sur la cause de l’erreur (voir gestion des erreurs).
Cas d’utilisation de fork
Exécution d’un autre programme : un shell utilise
fork+execpour lancer une nouvelle commande (ls,gcc…).Isolation et robustesse : un crash dans un processus n’affecte pas les autres (contrairement aux threads).
Services système : les démons/serveurs Unix (ex.
sshd,cron) créent un processus enfant par connexion ou tâche.Sécurité : sandboxing ou
chroot→ isoler un processus potentiellement dangereux.Traitement concurrent simple : lancer plusieurs programmes indépendants (ex. simulation parallèle où chaque processus travaille sur une portion différente de données, puis communication via pipes/sockets).
Communication inter-processus
Introduction
Un processus est isolé : il possède sa propre mémoire virtuelle et ne peut pas accéder directement à la mémoire des autres processus. Pour collaborer, les processus ont besoin de mécanismes de communication inter-processus (IPC, Inter-Process Communication).
Linux (et POSIX en général) propose plusieurs mécanismes IPC :
Signaux : messages simples envoyés par le noyau ou un autre processus (ex.
SIGINT,SIGKILL)Pipes : communication en flux entre processus apparentés
FIFO (pipes nommés) : pipes accessibles entre processus non apparentés
Files de messages : envoi/réception de messages structurés (non abordées dans ce cours)
Mémoire partagée : plusieurs processus accèdent à une même zone mémoire (non abordée dans ce cours)
Sémaphores : synchronisation d’accès à des ressources partagées (non abordés dans ce cours)
Sockets : communication locale ou réseau (voir chapitre Sockets)
Signaux
Un signal est un message très simple (un numéro) envoyé à un processus. C’est un mécanisme asynchrone : le signal peut arriver à n’importe quel moment de l’exécution du processus qui le reçoit. Il peut être généré par :
le clavier (Ctrl+C →
SIGINT) ;un autre processus (commande
killou fonctionkill) ;le noyau (division entière par zéro →
SIGFPE).
La commande kill -L permet de lister les différents signaux (voir aussi man 7 signal) :
$ kill -L
 1) SIGHUP   2) SIGINT       3) SIGQUIT      4) SIGILL       5) SIGTRAP
 6) SIGABRT  7) SIGBUS       8) SIGFPE       9) SIGKILL     10) SIGUSR1
11) SIGSEGV 12) SIGUSR2     13) SIGPIPE     14) SIGALRM     15) SIGTERM
16) SIGSTKFLT       17) SIGCHLD     18) SIGCONT     19) SIGSTOP     20) SIGTSTP
... jusqu'à 64
Les signaux les plus courants (numéros sous Linux) :
Signal |
N° |
Origine habituelle |
Effet par défaut |
Interceptable |
|---|---|---|---|---|
|
1 |
fermeture du terminal / déconnexion |
termine le processus |
oui |
|
2 |
Ctrl+C |
termine le processus |
oui |
|
9 |
|
termine le processus |
non |
|
13 |
noyau : écriture dans un pipe sans lecteur |
termine le processus |
oui |
|
15 |
|
termine le processus |
oui |
|
17 |
noyau : un enfant s’est terminé |
ignoré |
oui |
|
18 |
|
reprend un processus stoppé |
oui |
|
19 |
|
stoppe le processus |
non |
|
20 |
Ctrl+Z |
stoppe le processus |
oui |
Depuis le terminal, on peut désigner le signal de trois manières :
# avec son numéro :
kill -9 <pid>
# le nom complet du signal :
kill -SIGKILL <pid>
# le nom sans le préfixe SIG :
kill -KILL <pid>
# sans option, kill envoie SIGTERM :
kill <pid>
Exemple d’utilisation :
$ # ouverture de mon_fichier.txt avec gedit en arrière-plan
$ gedit mon_fichier.txt &
[1] 202266
$ # envoi d'un signal SIGINT au processus
$ kill -SIGINT 202266
[1]+  Interrompre             gedit mon_fichier.txt
Envoyer un signal en C : kill
La fonction kill (<signal.h>, man 2 kill) est l’équivalent en C de la commande kill :
int kill(pid_t pid, int sig);
pid: PID du processus destinatairesig: signal à envoyer (SIGTERM,SIGINT…)
Retourne 0, ou -1 en cas d’erreur (errno indique la cause).
Par exemple, le parent demande à son enfant de s’arrêter :
if (kill(pid_enfant, SIGTERM) == -1) {
    perror("kill");
}
kill est une fonction POSIX : avec -std=c2x, il faut la macro #define _POSIX_C_SOURCE 200809L (ou #define _GNU_SOURCE) avant les #include (voir la note du cours).
Intercepter un signal : sigaction
Un processus peut intercepter un signal avec une fonction appelée handler (gestionnaire), de signature void nom_du_handler(int sig) (le nom est libre, on_signal dans l’exemple ci-dessous).
Le handler ne s’exécute pas « quand le programme a fini ce qu’il faisait » : il interrompt le programme là où il en est, entre deux instructions quelconques, puis le programme reprend exactement au même endroit.
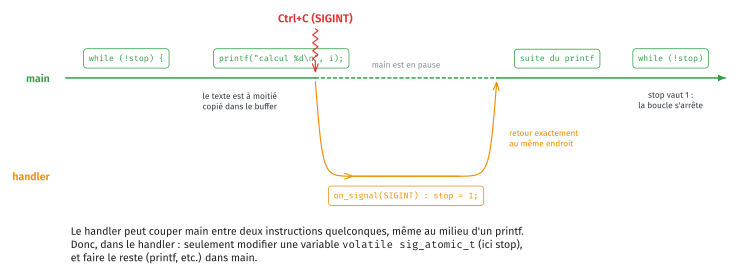
D’où deux règles :
le handler se contente de modifier une variable de type
volatile sig_atomic_t(un « drapeau ») ;tout le reste (affichage, arrêt de la boucle…) est fait dans le programme principal, qui teste ce drapeau.
printf est à éviter dans le handler : il peut interrompre un printf du programme principal, alors que le buffer de stdout est à moitié rempli.
Le handler est installé avec la fonction sigaction (<signal.h>, man 2 sigaction) :
int sigaction(int signum,
              const struct sigaction *act,
              struct sigaction *oldact);
signum: signal à intercepter (SIGINT…)act: nouvelle action, décrite par unestruct sigaction(le handler, les signaux bloqués, les options)oldact: adresse où enregistrer l’action précédente, ouNULLsi on ne s’y intéresse pas
Retourne 0, ou -1 en cas d’erreur (errno indique la cause).
Comme pour kill, avec -std=c2x, sigaction et struct sigaction ne sont déclarées que si #define _POSIX_C_SOURCE 200809L est placé en première ligne, avant tous les #include (voir la note sur _POSIX_C_SOURCE).
L’installation suit toujours la même recette :
struct sigaction sa = {0};      // structure dont tous les champs valent 0
sa.sa_handler = on_signal;      // la fonction à appeler (pointeur de fonction)
sigemptyset(&sa.sa_mask);       // aucun signal supplémentaire bloqué pendant le handler
sa.sa_flags = SA_RESTART;       // relancer read, write, wait… s'ils sont interrompus
if (sigaction(SIGINT, &sa, NULL) == -1) {   // SIGINT sera désormais intercepté
    perror("sigaction");
    exit(EXIT_FAILURE);
}
sa_handlerreçoit le nom de la fonction, sans parenthèses : c’est un pointeur de fonction (voir Pointeurs de fonctions) ;sa_maskest l’ensemble des signaux bloqués pendant l’exécution du handler, vidé avecsigemptyset(le signal en cours de traitement est déjà bloqué par défaut) ;sa_flagsvaut en généralSA_RESTART, pour que certains appels bloquants (read,write,wait, etc.) soient relancés automatiquement s’ils sont interrompus par un signal (mettre0si, au contraire, vous souhaitez gérer un échec avecEINTR).
Note
Certaines fonctions comme sleep, nanosleep ou pause ne sont jamais relancées automatiquement, même avec SA_RESTART : un sleep est interrompu dès qu’un signal intercepté arrive. Il faut alors gérer soi-même la reprise.
Le champ sa_mask est de type sigset_t, un ensemble de signaux, que l’on manipule avec les fonctions suivantes (<signal.h>, man 3 sigsetops) :
int sigemptyset(sigset_t *set);
int sigaddset(sigset_t *set, int signum);
int sigdelset(sigset_t *set, int signum);
int sigismember(const sigset_t *set, int signum);
set: l’ensemble de signaux (par exemple&sa.sa_mask)signum: le signal à ajouter, retirer ou tester
sigemptyset vide l’ensemble, sigaddset y ajoute un signal, sigdelset en retire un, et sigismember teste si un signal en fait partie.
Retourne 0 (pour sigismember : 1 si le signal fait partie de l’ensemble, 0 sinon), ou -1 en cas d’erreur (errno indique la cause).
Vous trouverez aussi la fonction signal() dans d’anciens codes : c’est une interface plus ancienne, dont le comportement varie selon les systèmes ; préférez sigaction.
Exemple : intercepter SIGINT (Ctrl+C) pour arrêter proprement une boucle :
 1#define _POSIX_C_SOURCE 200809L // pour sigaction avec -std=c2x
 2#include <signal.h> // sigaction, sig_atomic_t, SIGINT
 3#include <stdio.h>  // printf, perror
 4#include <stdlib.h> // EXIT_SUCCESS, EXIT_FAILURE
 5#include <unistd.h> // pause, getpid
 6
 7// drapeau modifié par le handler
 8volatile sig_atomic_t stop = 0;
 9
10void on_signal(int sig) {
11    (void)sig; // paramètre inutilisé : évite l'avertissement « unused parameter »
12    stop = 1;  // demande l'arrêt de la boucle
13}
14
15int main(void) {
16    // installation du handler, selon la recette ci-dessus
17    struct sigaction sa = {0};
18    sa.sa_handler = on_signal;
19    sigemptyset(&sa.sa_mask);
20    sa.sa_flags = SA_RESTART;
21    if (sigaction(SIGINT, &sa, NULL) == -1) { perror("sigaction"); return EXIT_FAILURE; }
22
23    printf("PID = %d. Appuyez sur Ctrl+C pour envoyer SIGINT.\n", getpid());
24    while (!stop) {
25        pause(); // endort le processus jusqu'à l'arrivée d'un signal
26    }
27    printf("\nSIGINT reçu, fin de la boucle\n");
28    return EXIT_SUCCESS;
29}
Sortie :
PID = 12345. Appuyez sur Ctrl+C pour envoyer SIGINT.
^C
SIGINT reçu, fin de la boucle
Les variables partagées avec le handler (ici stop) sont de type volatile sig_atomic_t : sig_atomic_t est un type entier dont la lecture et l’écriture se font en une seule opération, même si un signal interrompt le programme ; volatile indique au compilateur que la valeur peut changer à tout moment (voir Autres mots-clés).
L’attente passive d’un signal se fait avec pause (<unistd.h>) :
int pause(void);
Met le processus en sommeil jusqu’à la réception d’un signal.
Quand le signal arrive, le handler s’exécute, puis pause retourne.
Retourne toujours -1, avec errno == EINTR.
Le nom lisible du signal est obtenu avec strsignal (<string.h>) :
char *strsignal(int sig);
sig: numéro du signal
Retourne une chaîne lisible correspondant au numéro de signal ("Interrupt" pour SIGINT).
Pour attendre une durée donnée plutôt qu’un signal, on utilise sleep (présentée plus haut).
Pour aller plus loin : champs et options de struct sigaction
struct sigaction permet de définir comment un processus réagit à un signal :
sa_handler: pointeur de fonction appelé à la réception du signal (prototypevoid (*)(int)).sa_sigaction: handler « étendu » (prototypevoid (*)(int, siginfo_t *, void *)) utilisé si le flagSA_SIGINFOest activé danssa_flags. Permet d’accéder à des informations supplémentaires danssiginfo_t(PID émetteur, code d’erreur, adresse fautive pourSIGSEGV, etc.).sa_mask: ensemble de signaux à masquer automatiquement pendant l’exécution du handler. On le prépare avec les fonctions sur signal set (voir plus haut), par exemplesigaddset(&sa.sa_mask, SIGTERM)pour masquer aussiSIGTERM.sa_flags: options de comportement, les plus utiles :SA_RESTART: relance certains appels bloquants interrompus par le signal (ex.read,write,wait)SA_SIGINFO: activesa_sigactionau lieu desa_handler(handler 3 arguments)SA_NOCLDSTOP: ne pas recevoirSIGCHLDquand un enfant est stoppé (seulement quand il meurt)SA_NOCLDWAIT: ne crée pas de zombies pour les enfants (le noyau les « récolte » automatiquement)SA_NODEFER: le signal courant n’est pas bloqué pendant l’exécution du handler (attention aux réentrances)SA_RESETHAND: après la première exécution, rétablitSIG_DFLpour ce signal
Limite de la boucle while (!stop) pause(); : si le signal arrive entre le test !stop et l’appel à pause(), le processus reste bloqué jusqu’au signal suivant. C’est acceptable pour un exemple avec Ctrl+C manuel ; la solution robuste est sigsuspend (man 2 sigsuspend, hors programme).
Pipes anonymes
Un pipe est un canal de communication unidirectionnel entre deux processus apparentés (souvent un parent et son enfant).
Il est créé avec pipe (<unistd.h>) :
int pipe(int fd[2]);
fd: tableau de deux entiers, qui reçoit deux descripteurs de fichier :fd[0]pour l’extrémité lecture (sortie du pipe),fd[1]pour l’extrémité écriture (entrée du pipe)
Retourne 0, ou -1 en cas d’erreur (errno indique la cause).
La lecture et l’écriture se font avec read et write. Il est aussi possible d’utiliser la libc pour simplifier les échanges.
Si on veut échanger des messages dans les deux sens, alors il faut créer deux pipes.
Le pipe est créé avant le fork : comme fork copie la table des descripteurs (voir Descripteurs de fichiers copiés), le parent et l’enfant ont alors chacun fd[0] et fd[1], soit 4 descripteurs vers le même pipe.
Chaque processus ferme ensuite l’extrémité qu’il n’utilise pas :
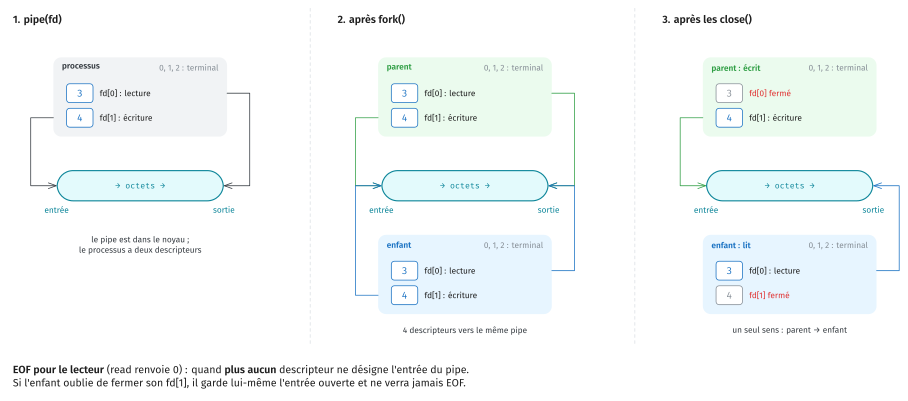
Un lecteur ne reçoit la fin de fichier (read retourne 0) que lorsque tous les descripteurs d’écriture du pipe sont fermés. Si le lecteur garde lui-même fd[1] ouvert, il ne verra jamais EOF.
À l’inverse, écrire dans un pipe dont toutes les extrémités de lecture sont fermées envoie le signal SIGPIPE à l’écrivain, qui est alors tué (même mécanisme pour les sockets, voir Sockets).
Exemple complet, où l’enfant envoie un message au parent, qui lit jusqu’à la fin de fichier :
 1#define _POSIX_C_SOURCE 200809L
 2#include <stdio.h>
 3#include <stdlib.h>
 4#include <string.h>
 5#include <sys/wait.h>
 6#include <unistd.h>
 7
 8int main(void) {
 9    int fd[2]; // fd[0] = lecture, fd[1] = écriture
10    if (pipe(fd) == -1) { perror("pipe"); exit(EXIT_FAILURE); }
11
12    pid_t pid = fork();
13    if (pid == -1) { perror("fork"); exit(EXIT_FAILURE); }
14
15    if (pid == 0) { // Enfant : il écrit
16        close(fd[0]); // ferme le côté lecture
17        const char *msg = "calcul terminé\n";
18        if (write(fd[1], msg, strlen(msg)) == -1) { perror("write"); }
19        close(fd[1]); // le parent pourra recevoir EOF
20        _exit(0);
21    } else { // Parent : il lit jusqu'à EOF
22        close(fd[1]); // ferme le côté écriture, sinon pas d'EOF
23        char buf[64];
24        ssize_t n;
25        while ((n = read(fd[0], buf, sizeof(buf) - 1)) > 0) {
26            buf[n] = '\0'; // read n'ajoute pas de '\0' à la fin des octets lus
27            printf("Parent a reçu : %s", buf);
28        }
29        if (n == -1) { perror("read"); }
30        close(fd[0]);
31        waitpid(pid, NULL, 0);
32    }
33    return 0;
34}
Sortie :
Parent a reçu : calcul terminé
Un pipe transporte un flux d’octets, pas des messages : deux write successifs ("ping#1" puis "ping#2") peuvent être reçus par un seul read ("ping#1ping#2"), et un read peut aussi recevoir moins d’octets que ce qui a été écrit.
Pour découper des messages, on termine chacun par \n et on lit ligne par ligne, par exemple avec fgets (voir Simplifier les échanges avec la libc).
Pour voir les descripteurs d’un processus, et vérifier lesquels sont encore ouverts, listez /proc/<pid>/fd (un pipe apparaît sous la forme pipe:[numéro]) :
$ ls -l /proc/12346/fd
lrwx------ 1 user user 64 ... 0 -> /dev/pts/2
lrwx------ 1 user user 64 ... 1 -> /dev/pts/2
lrwx------ 1 user user 64 ... 2 -> /dev/pts/2
lr-x------ 1 user user 64 ... 3 -> pipe:[1234567]
FIFO
Une FIFO (First In First Out) est similaire à un pipe, mais existe dans le système de fichiers : il peut être ouvert par des processus non apparentés.
La FIFO est créée avec mkfifo (<sys/types.h>, <sys/stat.h>) :
int mkfifo(const char *pathname, mode_t mode);
pathname: chemin de la FIFOmode: permissions initiales (affectées par umask)
Retourne 0, ou -1 en cas d’erreur (errno indique la cause, EEXIST si le fichier existe déjà).
L’un des processus (ou les deux) crée la FIFO :
const char *path = "canal";
if (mkfifo(path, 0666) == -1 && errno != EEXIST) {
    // si errno == EEXIST, alors la FIFO existe déjà, pas d'erreur dans ce cas
    perror("mkfifo");
}
Chaque processus ouvre ensuite la FIFO avec open : O_RDONLY côté lecteur, O_WRONLY côté écrivain.
L”open est bloquant : il ne retourne que lorsque l’autre côté a lui aussi ouvert la FIFO.
Un programme lancé seul reste donc en attente, sans rien afficher, tant que l’autre n’est pas lancé : c’est normal.
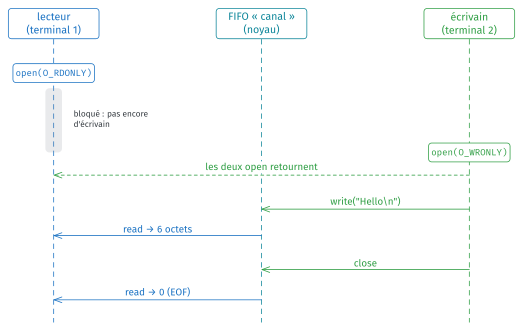
Les deux processus peuvent ainsi communiquer en écrivant d’un côté avec write(fd, message, taille_message) et en lisant de l’autre côté avec read(fd, buffer, taille_buffer).
On peut aussi utiliser la libc pour simplifier les échanges.
Comme pour un pipe, le lecteur reçoit EOF (read retourne 0) quand tous les écrivains ont fermé la FIFO.
Avant de terminer, chaque côté ferme la FIFO avec close(fd) (ou avec fclose s’il a créé un FILE * avec fdopen, car fclose ferme aussi le descripteur, voir plus bas).
À la fin, on peut supprimer la FIFO avec unlink (<unistd.h>) :
int unlink(const char *pathname);
pathname: chemin du fichier à supprimer (fichier ordinaire, FIFO…)
Supprime le nom pathname du système de fichiers. Un processus qui a encore ouvert le fichier peut continuer à l’utiliser : le fichier n’est réellement effacé qu’à sa dernière fermeture.
Retourne 0, ou -1 en cas d’erreur (errno indique la cause).
Par exemple, unlink(path); supprime la FIFO canal créée plus haut.
Vous pouvez aussi créer une FIFO dans le terminal :
mkfifo canal
# terminal 1
cat < canal
# terminal 2
echo "coucou" > canal
# terminal 1 affiche : coucou
Pour aller plus loin : ouverture non bloquante
Avec O_NONBLOCK (open(path, O_RDONLY | O_NONBLOCK)), l’ouverture en lecture retourne immédiatement, et l’ouverture en écriture échoue avec ENXIO s’il n’y a pas encore de lecteur.
Simplifier les échanges avec la libc
Pour simplifier l’échange de messages, il est possible de passer par les fonctions de la libc, comme fprintf et fgets, en créant un FILE * à partir du descripteur avec fdopen (<stdio.h>) :
FILE *fdopen(int fd, const char *mode);
fd: descripteur déjà ouvert (extrémité d’un pipe, FIFO ouverte avecopen…)mode:"r"ou"w", comme pour fopen ; il doit correspondre au mode d’ouverture du descripteur
Retourne un FILE * associé au descripteur, ou NULL en cas d’erreur (errno indique la cause).
Le FILE * ajoute un buffer de la libc devant le descripteur, comme pour un fichier (voir Bufferisation) : fprintf remplit le buffer, et les données ne partent dans le pipe que lorsque le buffer est vidé.
fdopen est une fonction POSIX : avec -std=c2x, il faut mettre #define _POSIX_C_SOURCE 200809L (ou #define _GNU_SOURCE) avant les #include, sinon elle n’est pas déclarée.
// côté parent : on envoie les données
// fd_ecriture : fd[1] pour un pipe, le résultat de open pour une FIFO
FILE *to_child = fdopen(fd_ecriture, "w");

// Le buffer est vidé à chaque '\n' (bufferisation par ligne)
setvbuf(to_child, NULL, _IOLBF, 0);

fprintf(to_child, "coucou!\n");

fclose(to_child);
// côté enfant : on reçoit les données
// fd_lecture : fd[0] pour un pipe, le résultat de open pour une FIFO
FILE *from_parent = fdopen(fd_lecture, "r");

char line[256];
if (fgets(line, (int)sizeof line, from_parent) != NULL) { // NULL : EOF ou erreur
    line[strcspn(line, "\r\n")] = '\0';
    printf("[enfant] le parent a envoyé : %s\n", line);
}

fclose(from_parent);
Par défaut, un FILE * obtenu avec fdopen sur un pipe ou une FIFO n’est vidé que lorsque son buffer est plein (bufferisation par bloc).
On change ce comportement avec setvbuf (<stdio.h>) :
int setvbuf(FILE *stream, char *buf, int mode, size_t size);
stream: le flux à configurer, juste après son ouverture (avant toute lecture ou écriture)buf: buffer à utiliser, ouNULLpour laisser la libc s’en chargermode:_IONBF(pas de buffer),_IOLBF(par ligne) ou_IOFBF(par bloc), détaillés plus bassize: taille debuf(0quandbufvautNULL)
Retourne 0, ou une valeur non nulle en cas d’erreur.
Par exemple, setvbuf(flux, NULL, _IOLBF, 0) passe le flux en bufferisation par ligne : le buffer est vidé à chaque \n, comme stdout sur un terminal.
Sans _IOLBF (ou sans fflush après chaque fprintf), le message resterait dans le buffer de l’écrivain, et le fgets d’en face attendrait jusqu’au fflush/fclose de l’écrivain.
Si l’écrivain attend lui-même une réponse, chaque processus attend l’autre : le programme est bloqué définitivement, sans message d’erreur.
Si un FILE * a été créé avec fdopen, on le ferme avec fclose, qui ferme aussi le descripteur : il ne faut donc pas appeler close en plus.
Pour aller plus loin : les trois modes de setvbuf
setvbuf(flux, NULL, mode, 0) choisit quand le buffer d’un flux en écriture est vidé :
_IONBF: pas de buffer, chaquefprintffait unwriteimmédiatement ;_IOLBF: bufferisation par ligne, le buffer est vidé à chaque\n(c’est le mode destdoutsur un terminal) ;_IOFBF: bufferisation par bloc, le buffer n’est vidé que lorsqu’il est plein, ou parfflush/fclose(c’est le mode par défaut d’unFILE *obtenu avecfdopensur un pipe ou une FIFO).